人工智能怎么做数据分析?这篇案例研究给出的答案是:不要把整份明细喂给大模型,而是让模型把你的需求翻译成可复用的处理脚本,数据在本机跑完,报告成文时只喂汇总指标。我们以某调味品供应链公司两份月结销售表(合计3816行)做了一次真实拆解——文中所有数据层结论均由本地脚本对原始文件逐项实跑复核,可复算。你会看到三个差点让报告作废的数据陷阱、一条"只在第一次付费"的成本曲线,以及五条可以带走的方法论。
本文要点
- 真实样本:两份月度销售表共3816行,全部数据层结论可复算
- 落地路线:云端生成脚本 + 本机执行 + 脚本留存,只在第一次付费
- 三大陷阱:总计行混入明细、两表内容完全相同、61.6%明细行零销量
- 实测收益:首次全链路约10分钟;复用1.33毫秒/次且零调用量
- 边界说清:处理环节本机跑,报告成文需联网调用模型接口
研究口径:本文为单案例深度研究。样本是某调味品供应链公司的8月、9月两份商品销售统计表(各15列、1908个数据行,单文件约166KB,合计3816行)。效率对比中的人工耗时为按标准操作步骤拆解的工时测算值(非秒表实测),测算口径在第三章注明。工具载体为本地安装的数以轻舟Agent。
一、背景介绍
1.1 人工智能怎么做数据分析:先看清它要解决的问题
回答「人工智能怎么做数据分析」之前,先要回答「数据分析里什么最费人」。三个被反复验证、却很少被真正解决的事实,构成了这项研究的起点。
第一,分析人员的时间大头不在分析。《哈佛商业评论》的调研口径被引用了很多年:数据分析师约80%的时间花在准备数据上,真正用来下结论的不到两成。这个比例放到月结场景会更极端——报表结构每个月都一样,变的只有数据,但每个月都要从头再做一遍。
第二,商业表格的错误率高得超出直觉。一项跨越35年、覆盖多国样本的学术综述给出的结论是:约94%的电子表格存在错误。表格类错误有个讨厌的特点:算错了不报错,账面看起来一切正常,直到某天对不上账才被发现。而月度汇总恰恰是把所有上游错误集中放大的最后一站。
第三,合规约束正在从建议变成红线。2025年1月1日起施行的《网络数据安全管理条例》(国务院令第790号),对数据处理者的义务做了更明确的规定;中国信通院《大模型专有云服务市场分析报告》显示,82%的企业倾向于私有化部署方式。销售明细、工资表、耗材台账这类表格,越来越多企业不愿意整份上传到网页工具的对话框里。
三条事实叠在一起,指向一个非常具体的需求:有没有一种做法,既用得上大模型的理解能力,又不用把整份明细交出去,还能让第二次、第三十次处理不再重复付费?这正是「人工智能怎么做数据分析」这个提问在实务中最该落地的答案。
1.2 三条技术路线,本案例站在哪一条
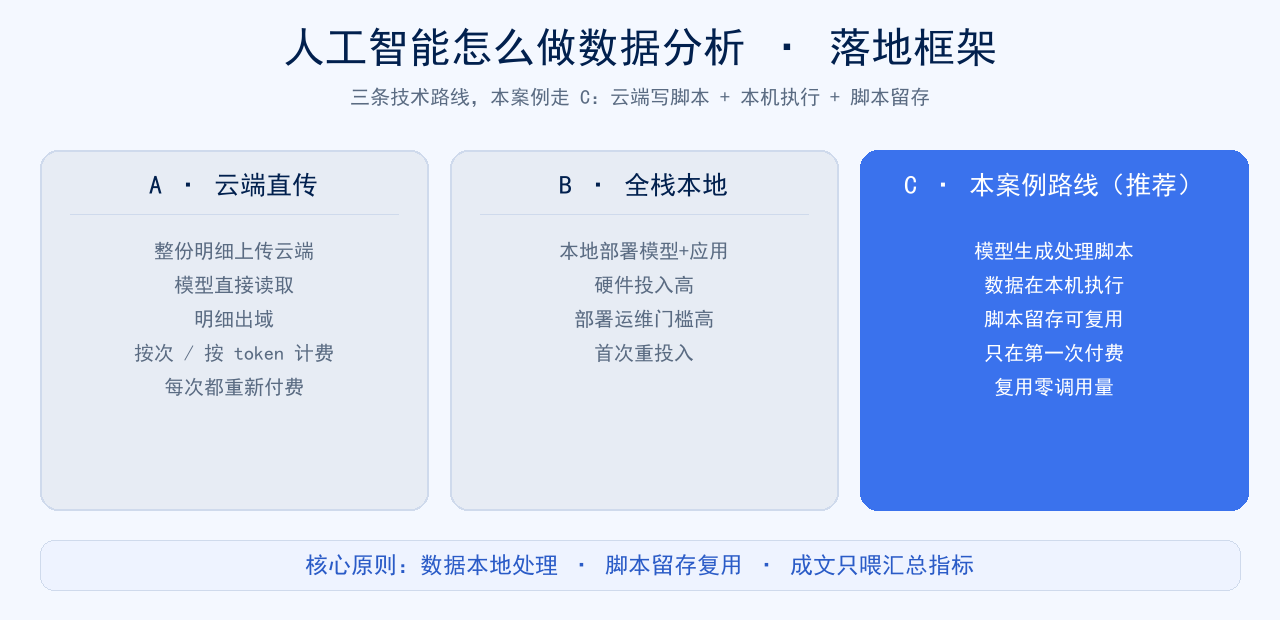
用大模型做表格分析,目前市面上的做法可以归成三条路线:
| 路线 | 代表做法 | 代价 |
|---|---|---|
| A · 云端直传 | 把整份表格上传到云端工具,模型直接读 | 明细出域、按次或按token计费、每次都重新付 |
| B · 全栈本地 | 本地部署模型加本地应用 | 硬件投入高、部署运维门槛高 |
| C · 云端生成脚本、本地执行、脚本留存 | 模型只负责把需求翻译成处理脚本,数据在本机跑 | 首次需要联网生成脚本,之后处理环节不再依赖模型 |
路线A的成本结构是「每次都全额付费」;路线B的成本结构是「一次性重投入」;路线C的成本结构是「只在第一次付费」。本次案例采用的正是路线C——数据文件在本机处理,模型负责生成可复用的处理脚本,脚本固化后同类任务直接本机复用。这也是「让AI做数据分析」最务实的落地形态:不是让模型逐行读你的明细,而是让模型把你的意图翻译成可复用的执行脚本,把重复的计算留在本机。
1.3 研究方法与样本说明
本次研究围绕三个问题展开:
- RQ1:AI能不能把数据质量问题挡在汇总之前,而不是等账对不上才发现?
- RQ2:省下来的时间究竟省在哪一步——是算得快,还是不用重做?
- RQ3:成本结构是什么样,第一次贵还是每次贵?
样本情况:两份xlsx文件,各15列、1908个数据行,字段包括商品名称、商品条码、货号、规格、单位、商品分类、现有库存、销售数量、商品总售价、实收金额、利润、利润率、商品品牌、商品供应商等;文件体积各约166KB,文本量合计约20.2万字符。任务目标:合并两个月度表、清洗、按商品分类汇总实收与利润、输出Top10单品与负利润清单,并交付一份能直接给管理层看的报告。
研究过程全程留痕:每一步的处理脚本、中间结果与最终文件都保存在本机指定目录,可回溯、可复算。
二、案例详情
2.1 案例主体与原有流程
案例主体是一家调味品供应链公司的销售内勤岗,每个月的固定动作是:从业务系统导出当月商品销售统计表,合并上月数据,按商品分类拆出汇总,做一份分类销售与利润报告,在月度经营会上用。
按原来的做法,这套活儿的标准流程是:把两份表复制到一张总表里,肉眼核对有没有重复,删掉表尾的总计行,然后用筛选加分类汇总把14个商品分类逐个拆出来,每个分类单独排一个Sheet,加标题、加表头、加边框、加序号,再回到总表算Top10和负利润清单,最后打开Word重新排一份报告——目录、图表、结论,一样一样贴。
按标准操作步骤拆解,这套动作要3.5到4.5个小时。更麻烦的是,它每月重来一次,而每一次都可能踩进同样的坑——本案例里,有3个坑差点让整份报告的结论作废,第三节会逐个拆。
2.2 新流程全记录
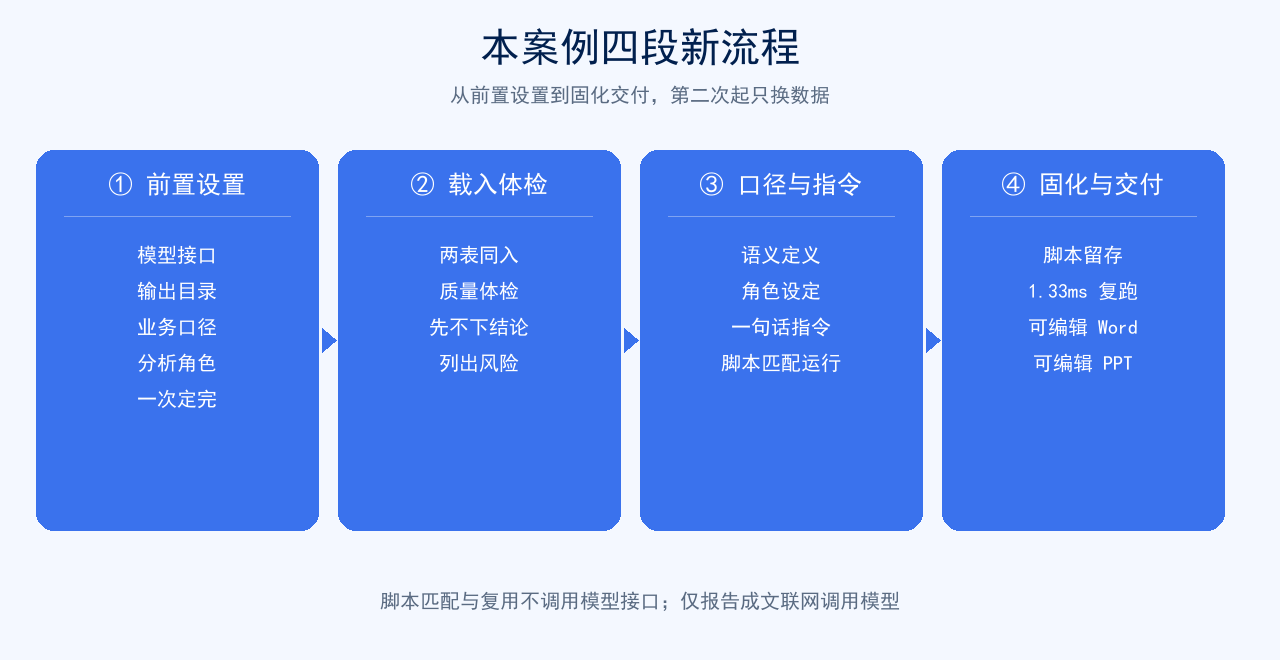
新流程的第一次跑通,分成四段:前置设置、载入体检、一句话下指令、报告交付。
第一段:前置设置,一次做好。模型接口、输出目录、业务口径、分析角色,四件事在动手前一次定完。模型接口方面,产品兼容Qwen、DeepSeek、Kimi、智谱、火山引擎、阿里百炼、小米MIMO等主流大模型接口,不绑定单一默认模型,算力自行接入——已经握着哪家的额度就用哪家。
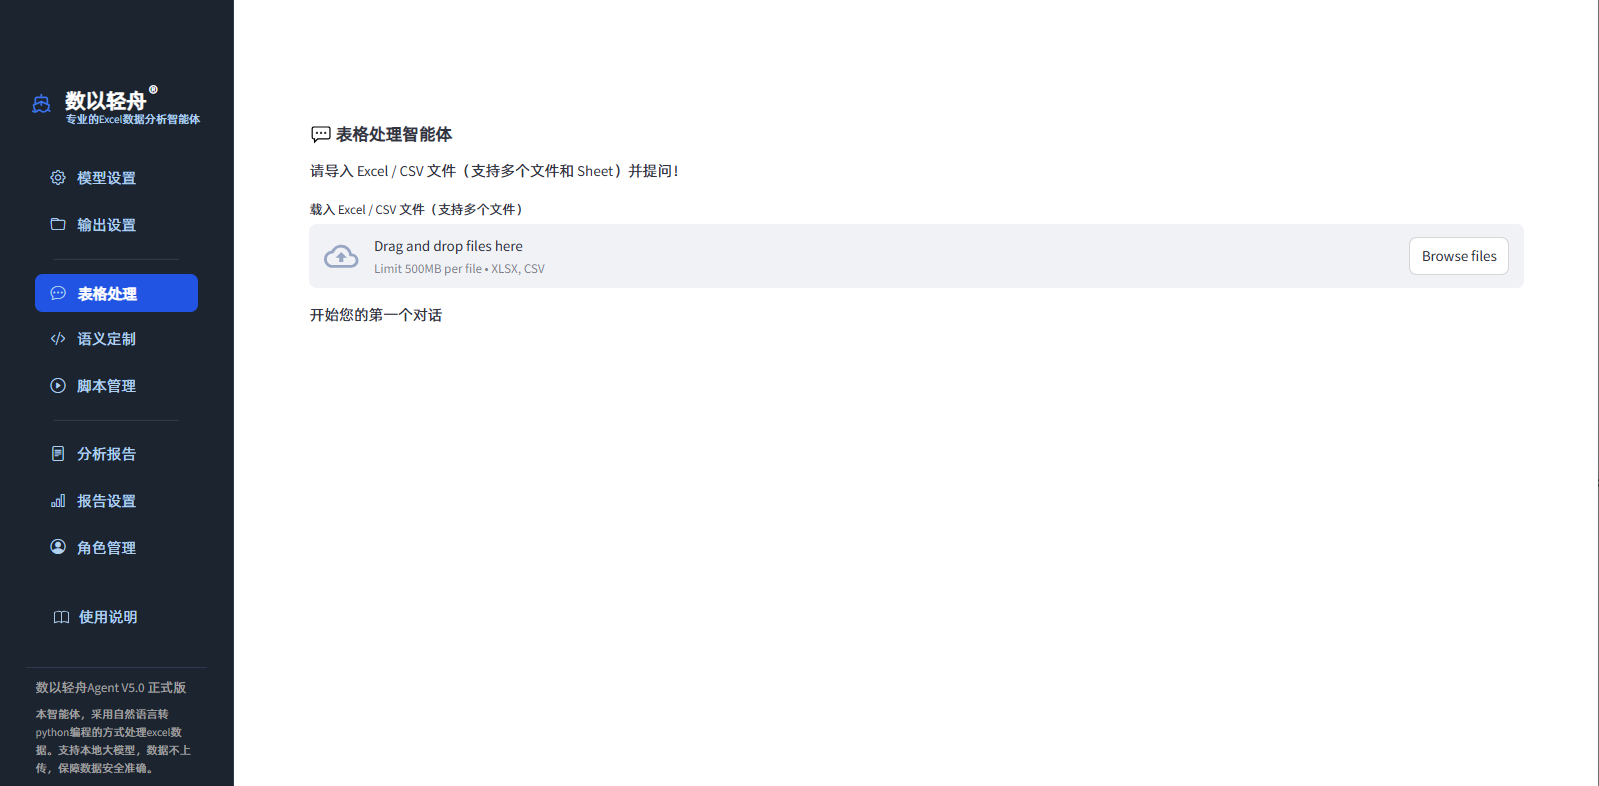
第二段:载入与体检。两份表一次放入,先做质量体检,不下任何结论。这一步是整条流程里最值钱的动作,体检结果直接改变了后面所有判断(见2.3节)。
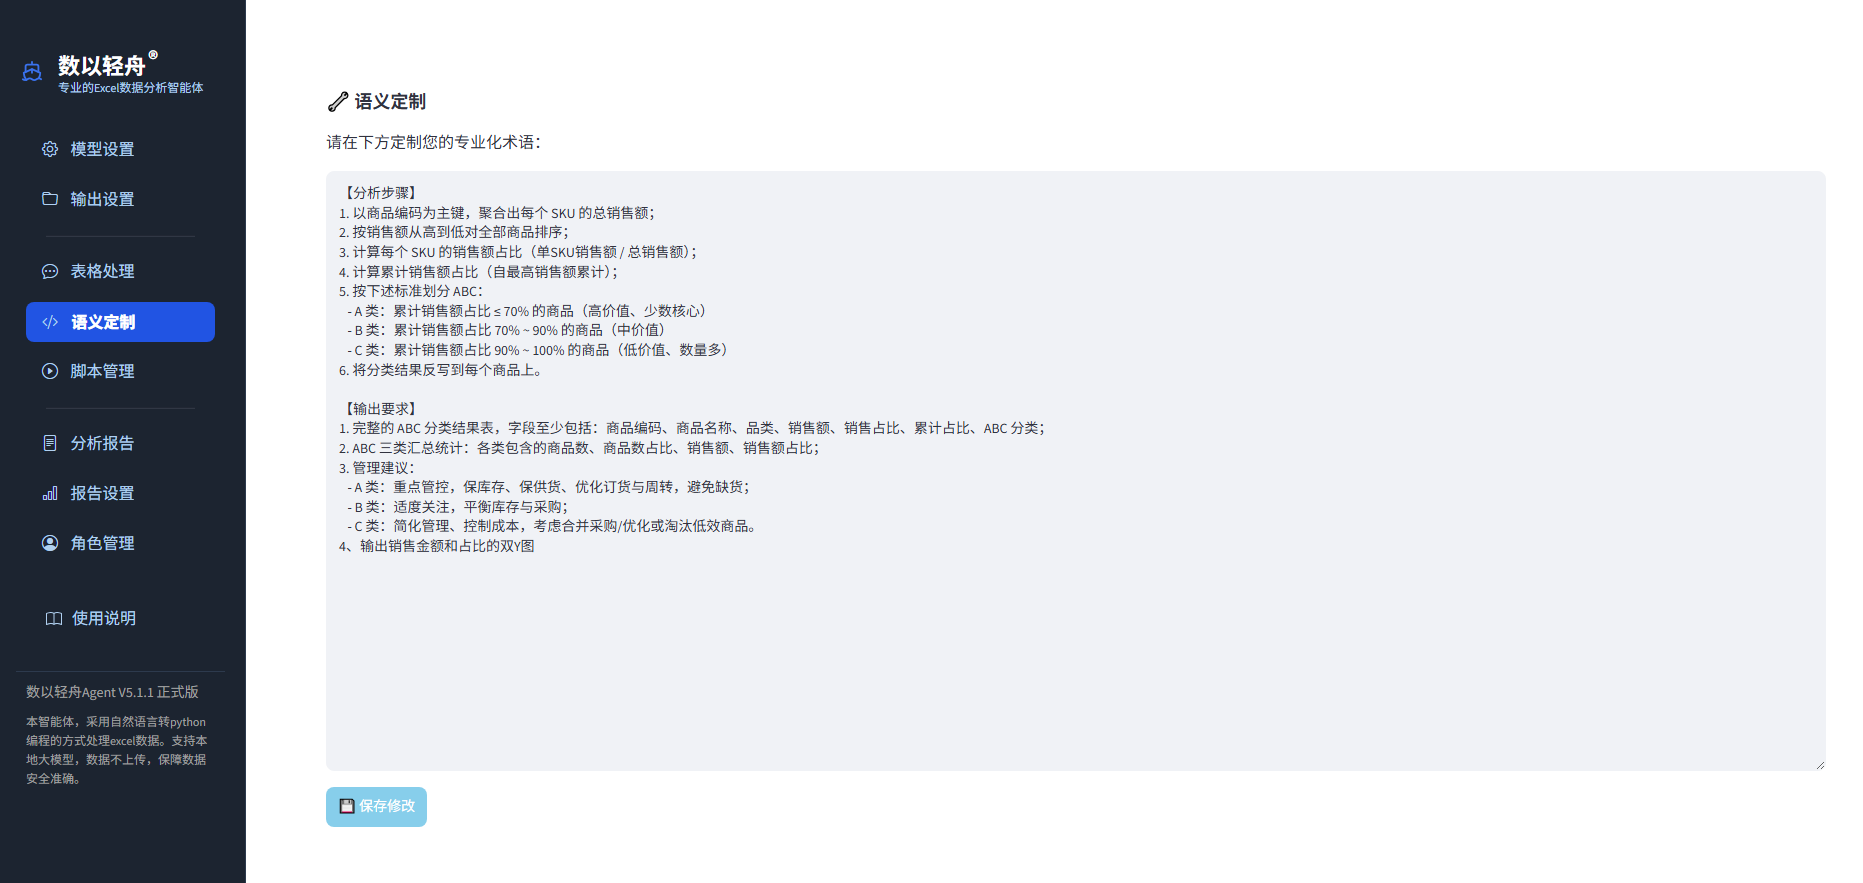
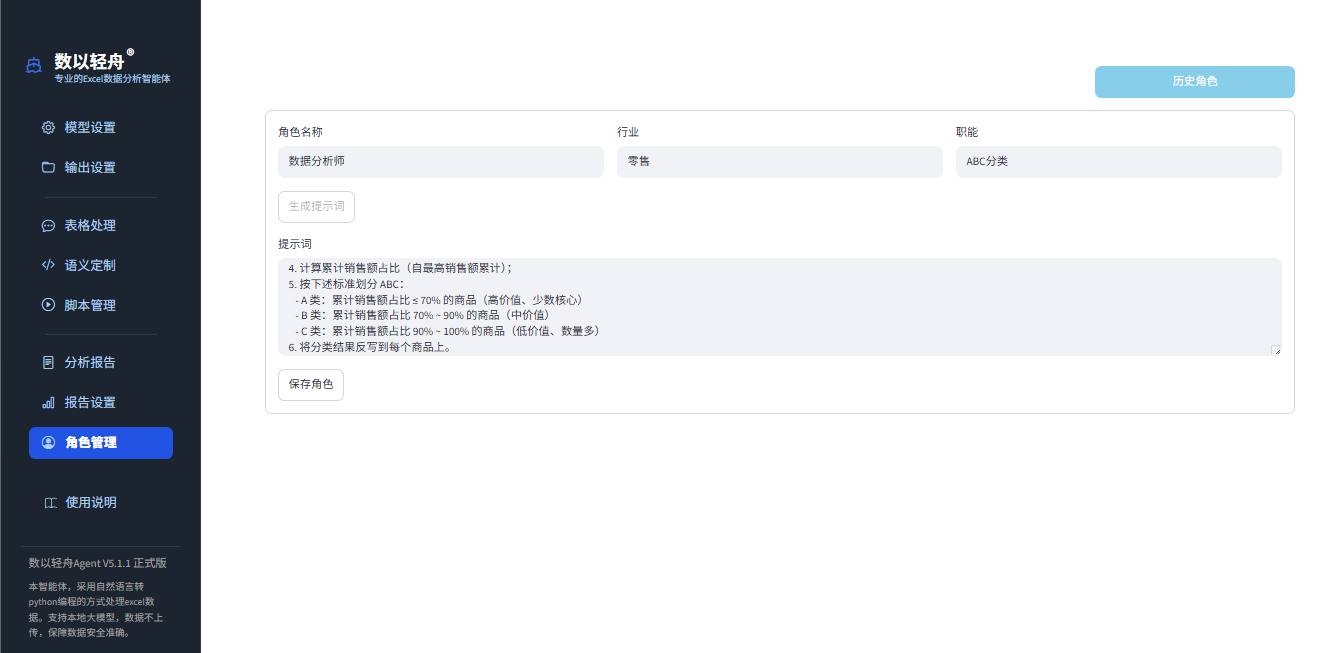
第三段:口径与指令。把公司的说法先写进语义定义——「实收金额」含不含税、「现有库存」负数代表什么、条码缺失怎么归类,写一次,之后每次都按这个来。再把分析角色设成供应链运营,报告的结构侧重会跟着角色走。
口径定完,只需要一句人话:把两份销售表合并,剔除商品名以「总计」开头的汇总行,去掉两表完全重复的记录,按商品分类汇总实收金额、利润与销售数量,输出Top10单品,标出利润为负与库存为负的记录。
指令发出后,系统做的是脚本匹配——按需求关键词匹配已保存的处理脚本,命中规则直接运行。这也是数以轻舟Agent区别于「每次都把整份明细喂给模型」做法的关键一步:脚本匹配这一步不调用模型接口,被消耗的只有后面的成文环节。
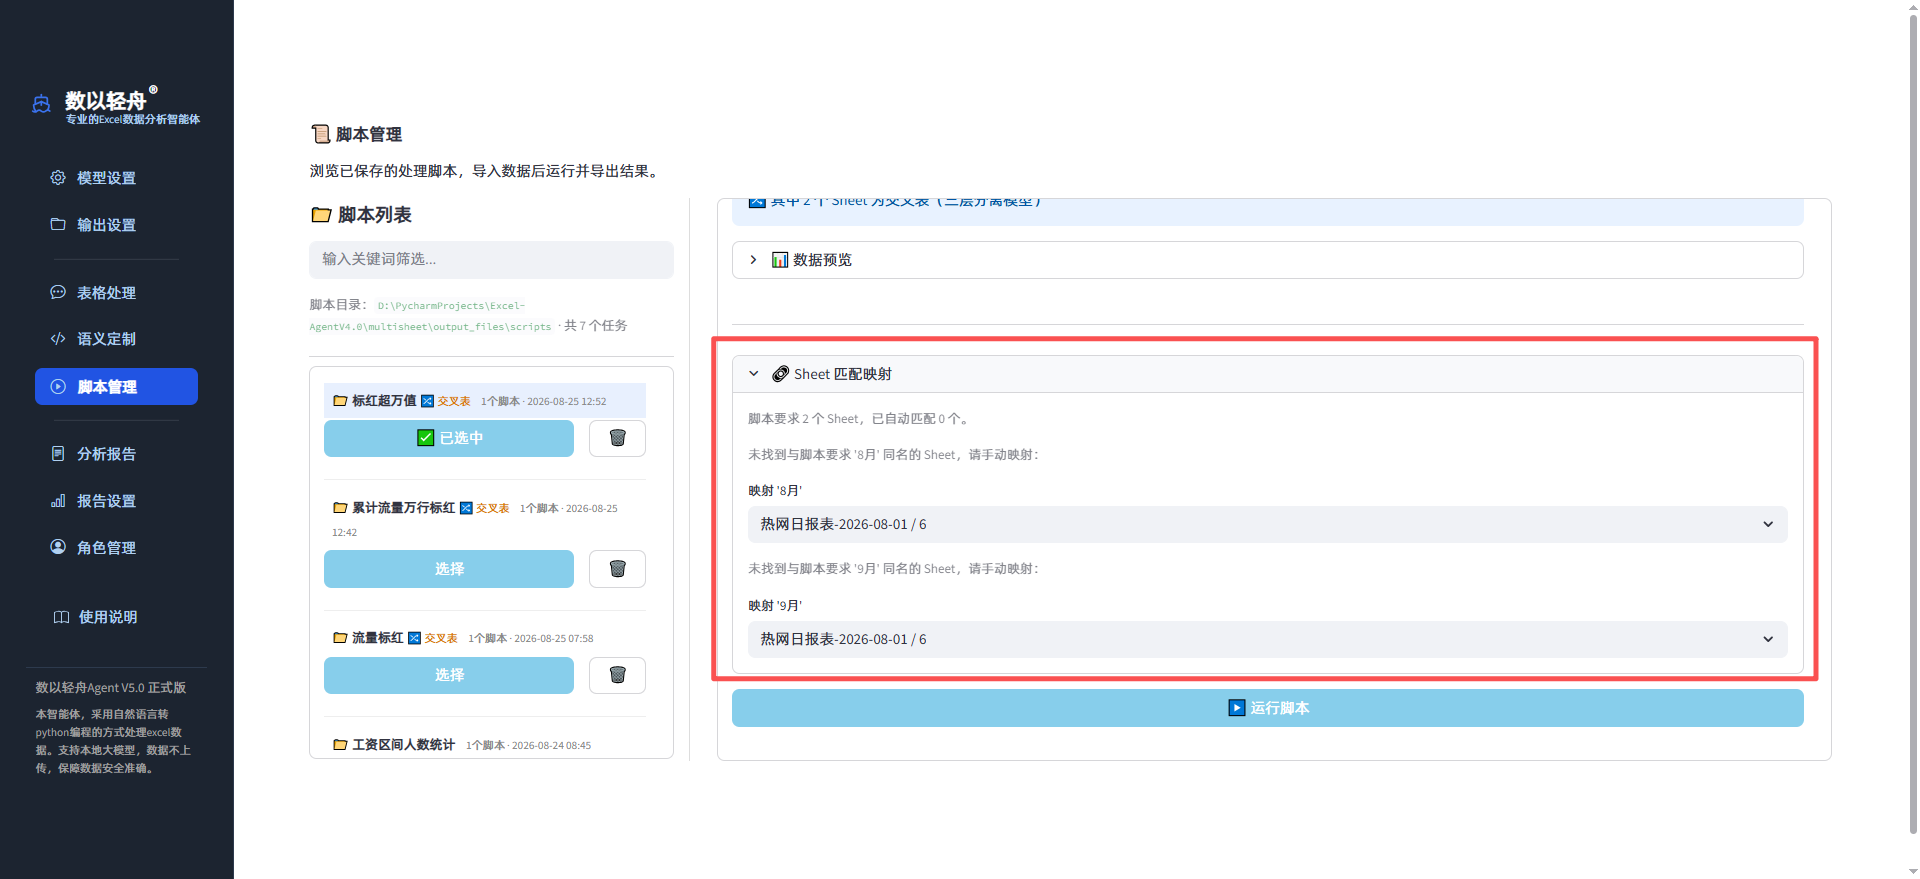
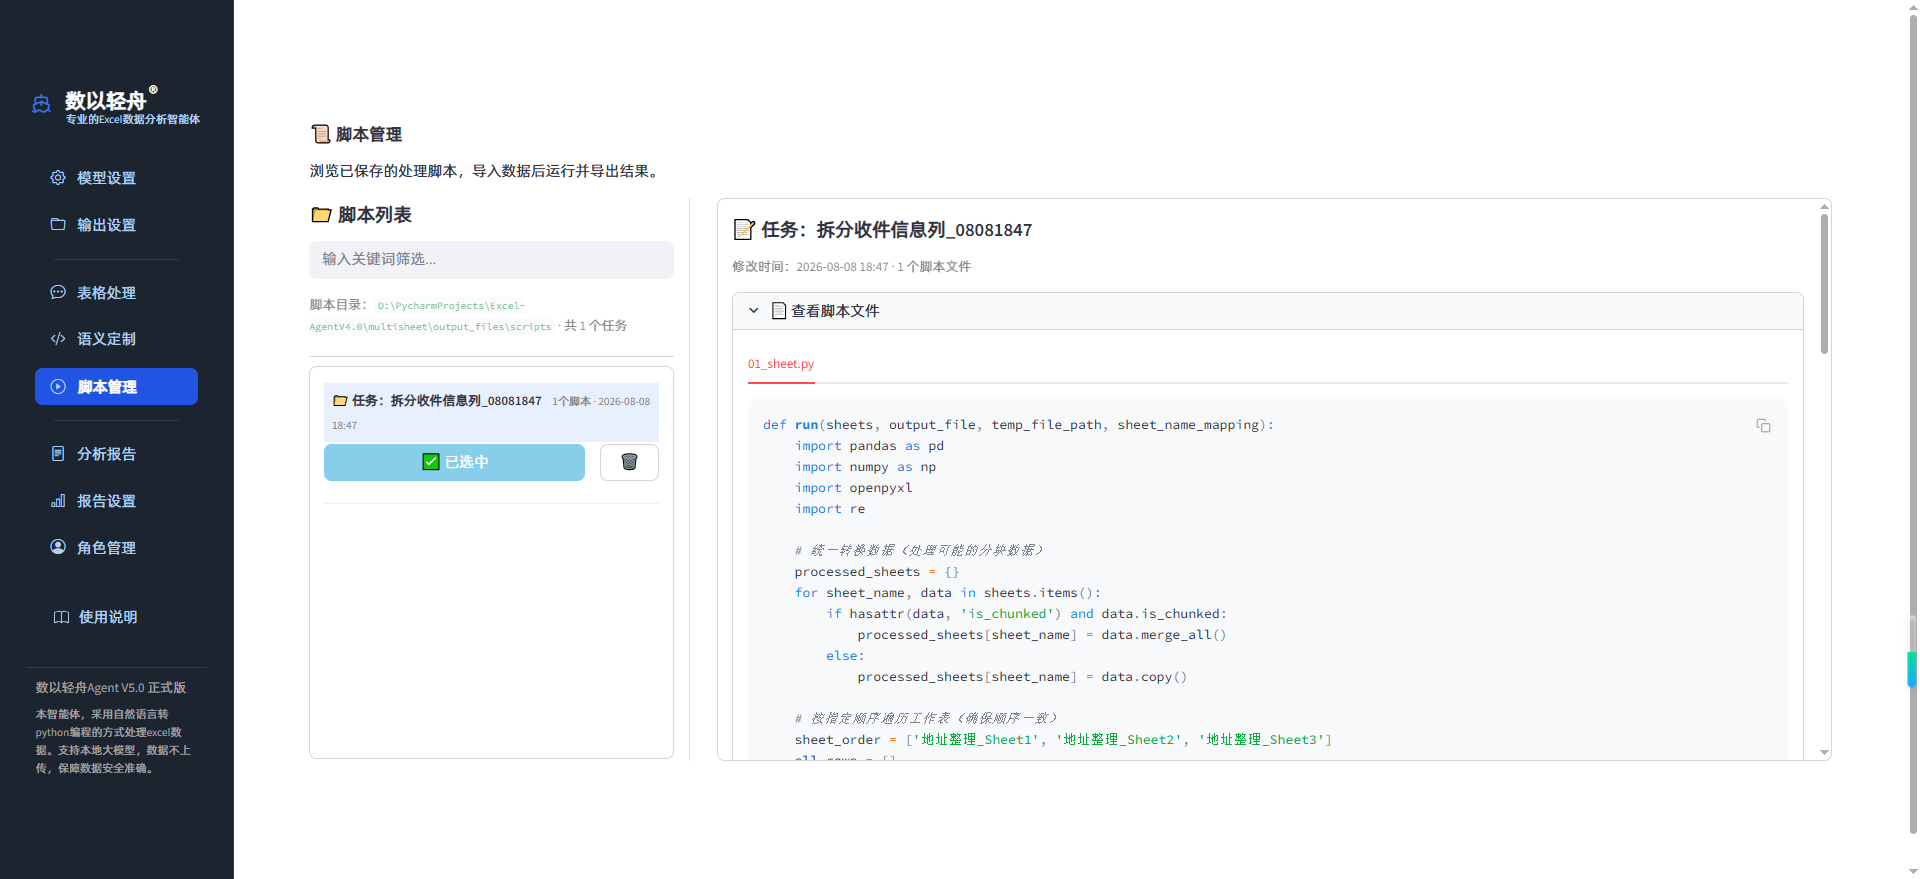
第四段:固化与交付。跑对一次之后,把脚本存下来。实测数值:首跑(读两张xlsx、清洗、两级聚合)570毫秒;之后复用同一套逻辑重跑,平均1.33毫秒一次,且不调用任何模型接口。
数据跑完进入报告环节。先看报告看板:核心指标、图表分层、自动小结同屏呈现;然后一键导出。
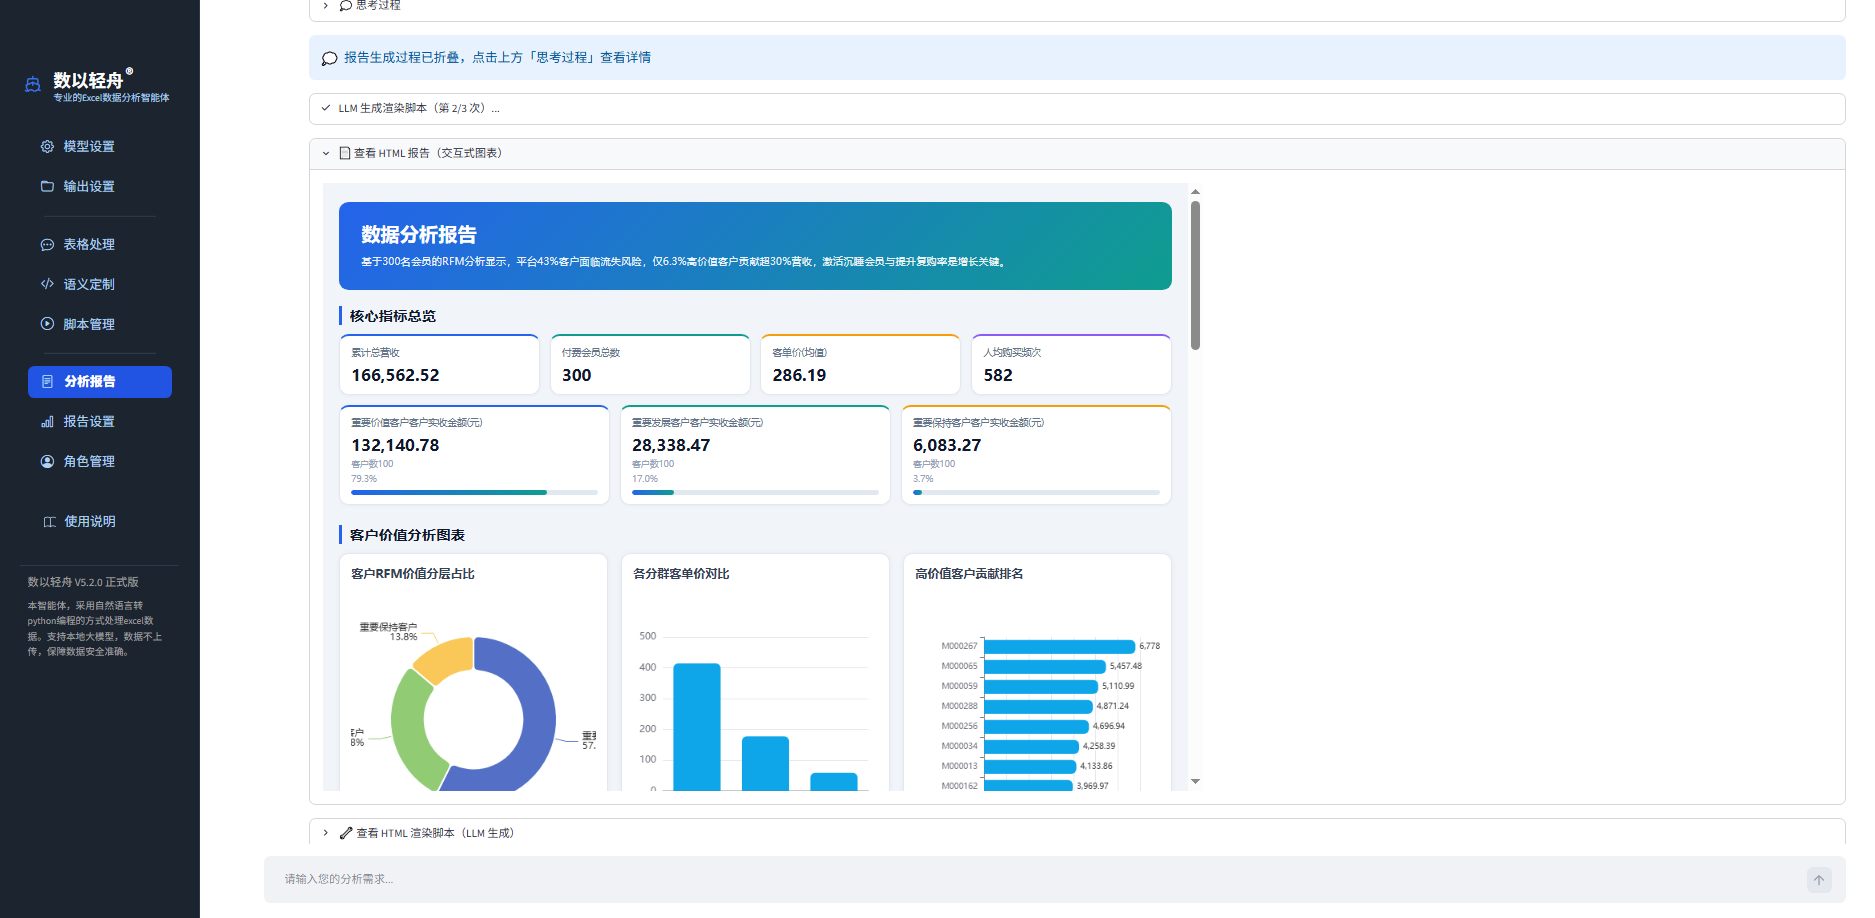
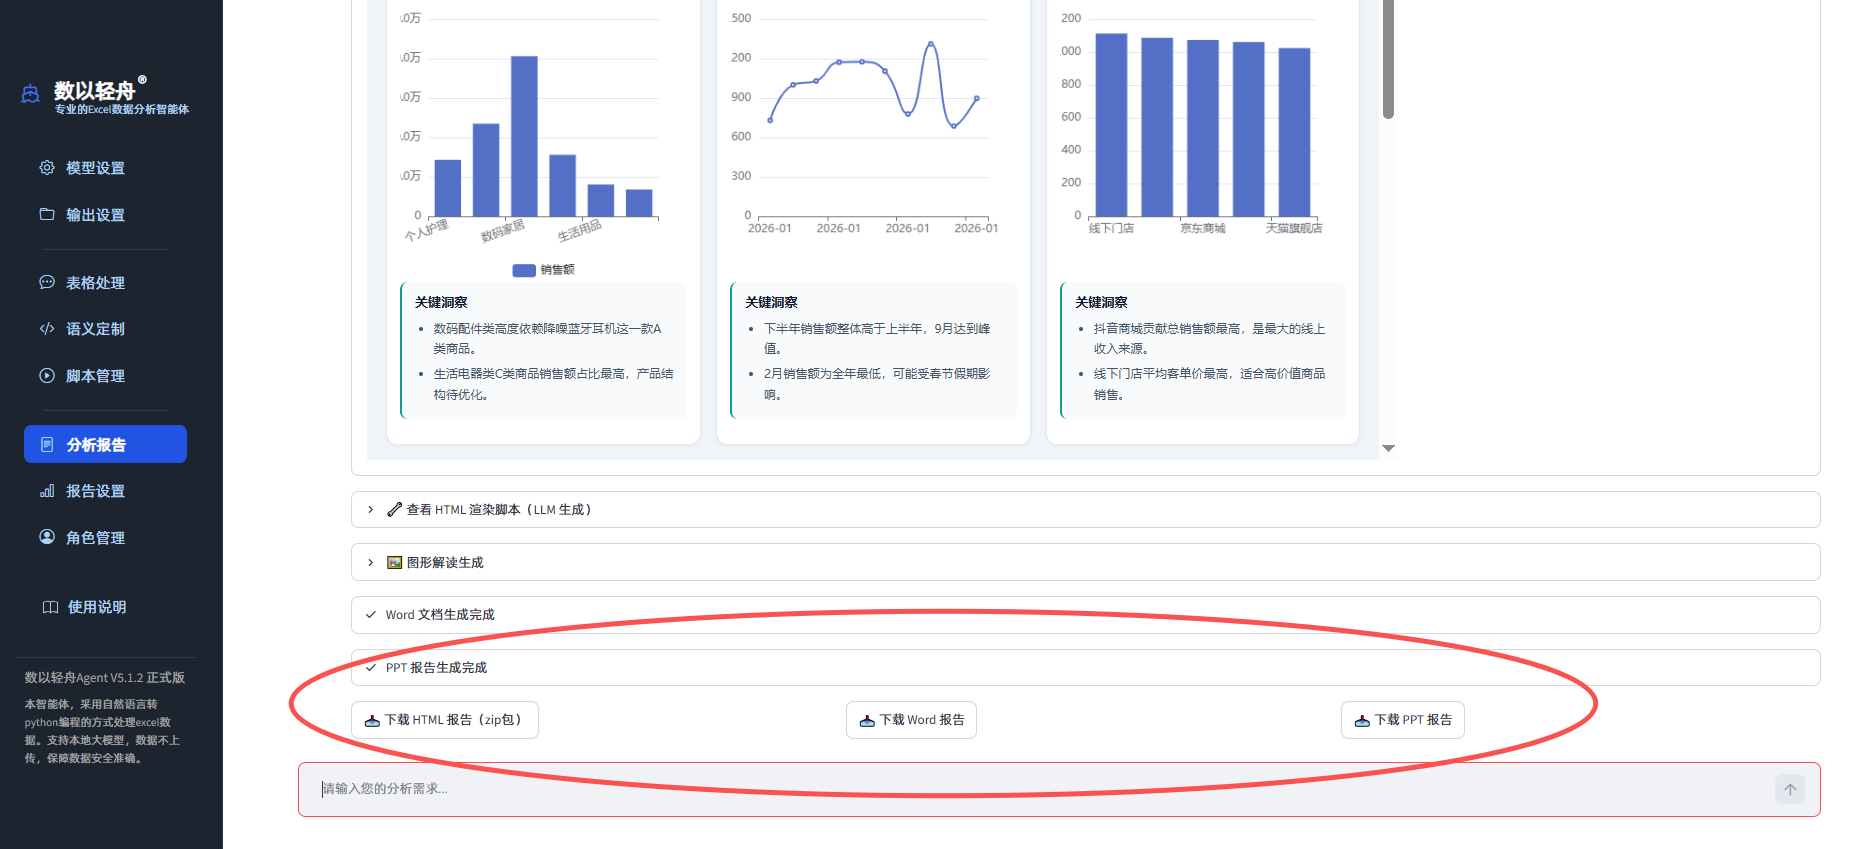
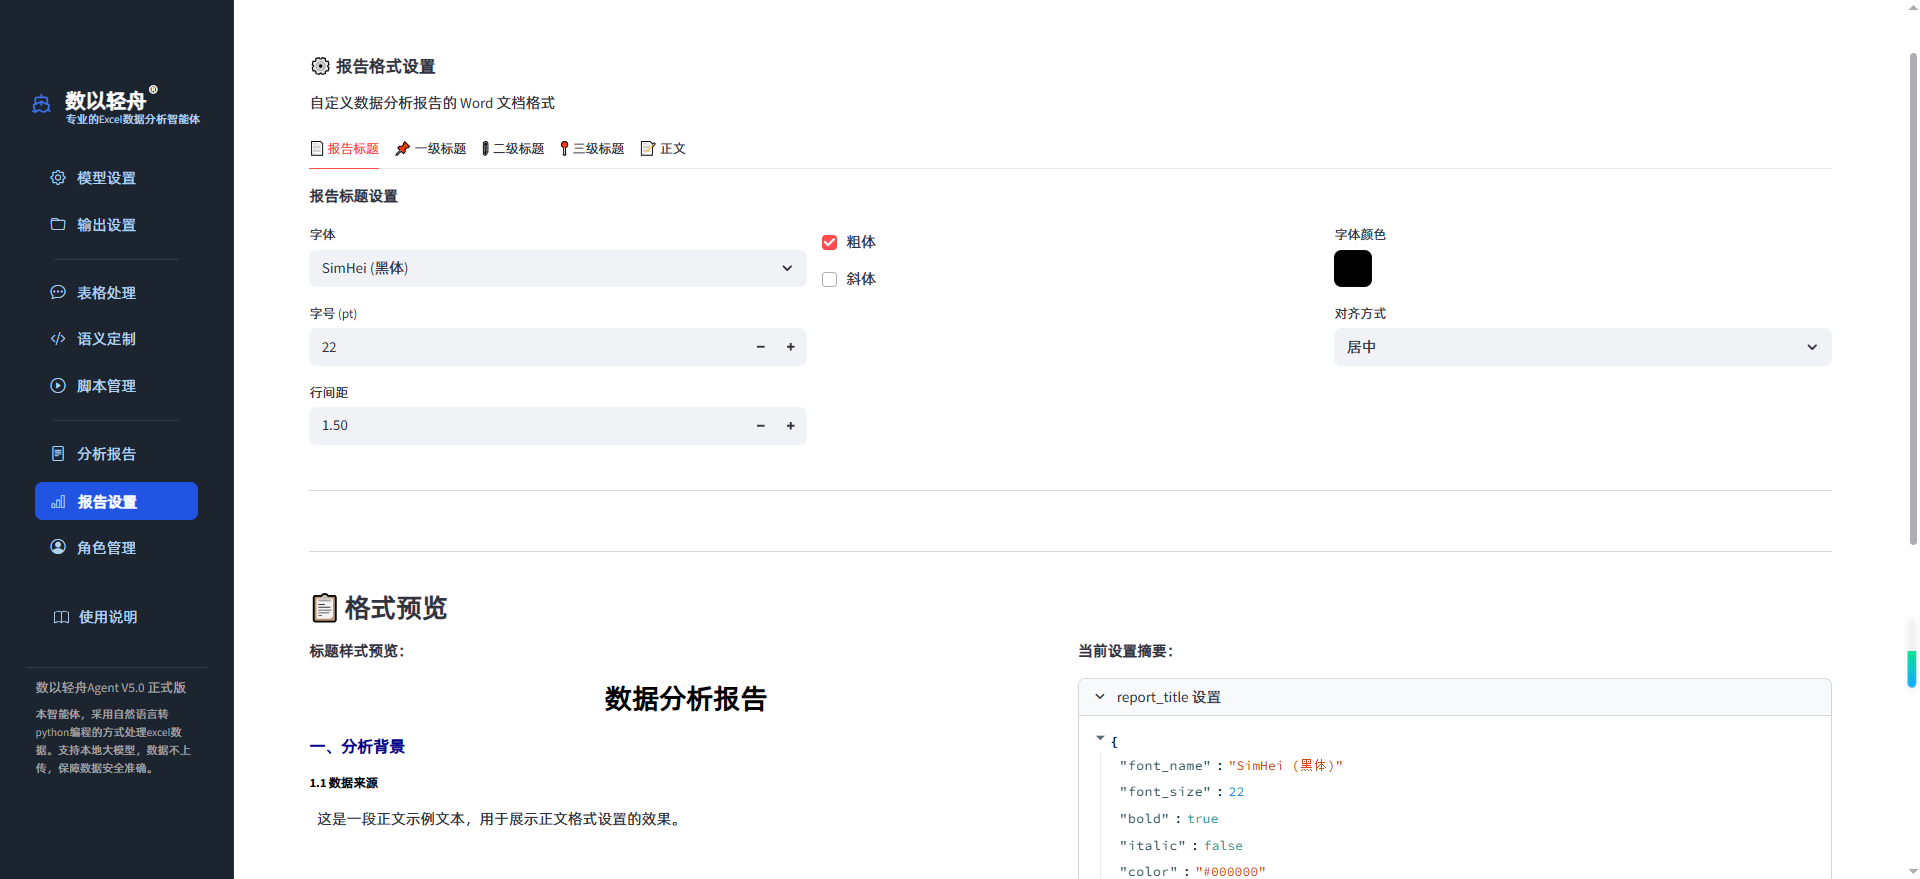
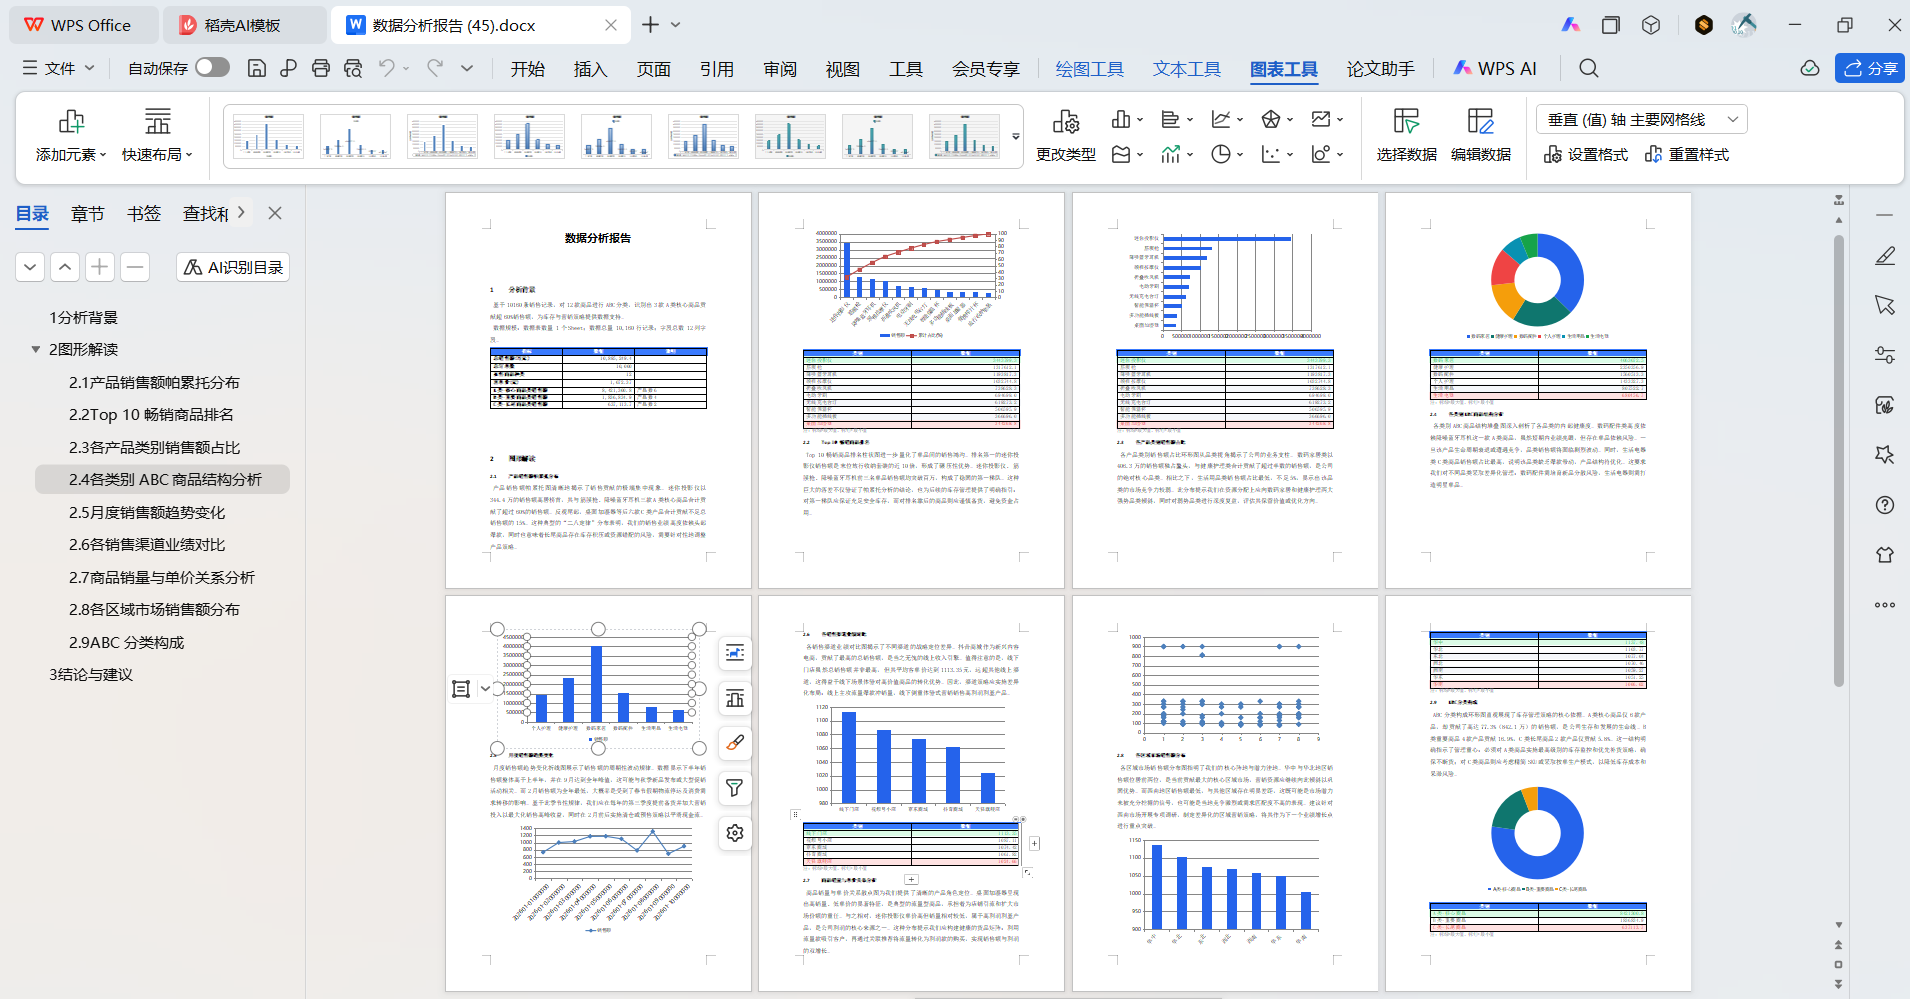

这里必须把边界说清楚,也是整个案例里最容易被误解的一点:表格的读、清洗、关联、汇总、透视,以及已固化的脚本复用,都在本机跑,复用时不调模型接口;而报告的文字组织、段落润色、图表说明这些成文动作,需要联网调用模型接口。省的是调用量,不是把整条链路搬进断网环境,两件事不能混为一谈。
2.3 三个差点让结论作废的转折点
案例研究的价值不在流程顺畅,而在哪里不顺。这次实跑有三个转折点,每一个都足以让一份「看起来正常」的报告直接作废。
转折点一:总计行混在明细里,账面直接翻倍。两份表的最后一行,商品名称列写着「总计:1907种商品」,分类列为空,实收金额各为406,800.55元。这种汇总行在业务系统导出表里非常常见。如果合并后直接求和,实收合计会算成1,627,202.20元;剔除汇总行后是813,601.10元——差了一倍,虚增的部分正好等于单月真实数。这类错误不靠模型靠规则,脚本把剔除规则写死,之后每次都不会再犯。
转折点二:两份月表,其实是同一份数据。体检结果显示,两表完全重复的记录有1907行——正好等于单表明细行数。也就是说,名为「8月表」和「9月表」的两份文件,内容一行不差,连总计都是同一个数。如果按两个月合并口径直接算环比,增长率是0%;如果按两月合计口径做业务汇报,所有金额都会虚高一倍。多收了一份文件,不等于多了一个月的数据——这句教训值得每个做合并汇总的人写在显示器边上。
转折点三:六成明细行根本没有销量。3814行明细里,销售数量为零的有2348行,占61.6%;这些行的实收金额同样为零,本质是商品主数据行而不是销售记录。如果直接拿全量明细算「有动销的商品占比」「平均单品贡献」,所有比例都会被严重稀释。真实有动销的记录只有1466行,而它们撑起了全部813,601.10元的实收。
三个转折点指向同一个结论:月结报告最大的风险不是算得慢,而是在脏数据上算得又快又自信。
三、数据分析
3.1 数据质量层:清洗前后的口径对照
| 检查项 | 实跑结果 | 影响 |
|---|---|---|
| 原始读入行数 | 3816行(两表各1908行) | 合并基数 |
| 混入的「总计」汇总行 | 2行,各406,800.55元 | 不剔除则合计虚增至1,627,202.20元 |
| 剔除后的明细行 | 3814行 | 有效合并口径 |
| 跨表完全重复行 | 1907行 | 两表内容完全一致,合并即翻倍 |
| 有动销的记录 | 1466行(占38.4%) | 其余61.6%为零销量主数据行 |
| 利润为负的记录 | 30行,合计利润-1,230.72元,涉及实收42,076.70元 | 需单独成清单,不能混入常规排名 |
| 库存为负的记录 | 174行(调料68、散称干货44、酱油醋32等) | 反映账实差异,需单独标注 |
清洗质量层的直接收益,是把「合计162万」这种会在经营会上被当场戳穿的数字,修正成了813,601.10元。
3.2 业务结构层:数据背后的经营事实
按合并口径(两表合计,剔除汇总行,未去重)汇总14个商品分类:
| 商品分类 | 实收(元) | 实收占比 | 毛利率 | 明细行数 |
|---|---|---|---|---|
| 油 | 339,360.76 | 41.71% | 3.49% | 232 |
| 调料 | 160,022.30 | 19.67% | 14.26% | 1,476 |
| 散称干货 | 81,653.72 | 10.04% | 21.35% | 510 |
| 其他XY | 78,940.00 | 9.70% | 5.42% | 332 |
| 酱油醋 | 63,748.44 | 7.84% | 12.51% | 608 |
| 大米 | 39,400.00 | 4.84% | 7.51% | 58 |
| 面条面粉 | 22,845.00 | 2.81% | 14.05% | 260 |
| 一次性用品 | 17,390.92 | 2.14% | 10.11% | 214 |
| 其余6类合计 | 10,239.96 | 1.26% | — | 124 |
若按去重后的单月口径,各项金额减半,占比与毛利率不变。
四个能直接拿去开会的结论:
- 油是盘子、不是利润。油类实收占全盘41.71%,毛利率只有3.49%;其中口福一级大豆油20L单品实收227,637.16元,独占27.98%,毛利率2.24%——近三成收入几乎不挣钱,属于典型的大进大出引流品。
- 散称干货才是利润奶牛。实收占比10.04%,毛利率21.35%,是全部14个分类里最高的。
- 行数与收入严重错位。调料分类有1476行明细、贡献19.67%收入;而面条面粉260行只贡献2.81%,一次性用品214行贡献2.14%——管理这些长尾分类的精力投入,和它们的收入贡献完全不成比例。
- 极端长尾结构。1198个商品里,Top5贡献44.37%的实收,前20%(239个)贡献94.52%,剩下959个加起来不到6%。此外还有3个零实收的空壳分类(散称、秒杀特价商品、餐饮推广专属产品,共36行)和一笔卖成负毛利的云烟(软珍品),实收33,256.00元、利润-0.84元。
3.3 效率与成本层:时间省在哪,钱省在哪
先看时间。人工口径为按标准操作步骤与一般熟练度拆解的工时测算值;工具侧处理耗时为本地实跑实测值。
| 环节 | 人工做法(工时测算) | 工具做法 |
|---|---|---|
| 两表合并与重复核对 | 30–40分钟 | 载入后体检自动列出,秒级 |
| 剔除汇总行并校验合计 | 约15分钟 | 脚本规则处理,含在首跑内 |
| 按14个分类拆Sheet并排版 | 90–110分钟 | 同一脚本一次性输出 |
| 分类汇总、Top10、负利润标注 | 约30分钟 | 同上 |
| Word报告排版(目录、图表、结论) | 40–60分钟 | 一键导出可编辑Word/PPT |
| 合计 | 约3.5–4.5小时/次 | 首次全链路约10分钟;此后处理环节1.33毫秒/次 |
注意一个常被忽略的细节:时间不是均匀省下来的。省得最多的是拆Sheet和排版这两段纯机械劳动,约占人工工时的六成;而数据体检发现的三个转折点,省下的其实不是时间,是「报告发出去之后被推翻重来」的代价。
再看成本。本案例两份表合计约20.2万字符,按中文约1.5字符折算1个token的口径粗估,全量明细约13.5万token。如果走「每次都把整份明细喂给模型」的路线,这个量每月重复一次,账单随次数线性上涨。而脚本复用路线的做法是:第一次生成脚本消耗一次调用量,之后12次月结的处理环节全部在本机跑完,成文环节只喂汇总指标——14个分类汇总加Top10加核心指标,只有两千字符量级,比喂全量明细低了约两个数量级。
这解释了一个行业现象:信通院口径显示,国内大模型API均价较2023年已下降超90%;第三方统计也显示,主流高能力模型每百万输出token的中位价从25美元降到2.8美元。单价跌了九成,但只要「每次全量重喂」的姿势不变,总账单依然随次数上涨——单价下降省的是每次的钱,脚本复用省掉的是「第二次」这件事本身。
3.4 交付物层:报告能不能被改,决定了它能不能被用
同类工具的输出多数是一张图或一个网页看板,截图能发,但领导要改一页、财务要加一行说明时就得重来。本案例交付的是三样东西:HTML看板用于快速浏览,可编辑Word用于正式归档,可编辑PPT用于月度经营会——图表元素可选中、可替换数据、可改版式。从「能生成」到「能交付」,中间差的正是这一层。
回到开头的三个研究问题,本案例给出的回答是:
- RQ1:能。三个数据质量陷阱全部在汇总之前被拦下,靠的是规则化体检而不是模型直觉。
- RQ2:省在两处——机械劳动不再重复做,以及口径固化后不再反复解释。前者省时间,后者省试错。
- RQ3:成本集中在第一次。首次生成脚本需要调用模型,之后同类任务的处理环节零调用量,成文环节只喂汇总指标。
四、经验总结
4.1 五条可复用的方法论
一、先体检,后汇总。任何合并动作之前,先跑一遍质量体检:汇总行、重复行、负值、空值、零销量行。体检结果决定后面用哪套口径。这一步的成本几乎为零,收益却是「报告不会被当场推翻」。
二、口径写成规则,不写在脑子里。「实收是不含税的」「负库存代表账实差异」「总计行要剔除」——这些说法如果只存在于老员工的脑子里,每次都要重新解释一遍,人一换就断。写进语义定义和处理脚本里,口径就变成了资产。
三、脚本是资产,不是副产品。首跑570毫秒、复用1.33毫秒,这个差距本身不重要;重要的是复用不消耗调用量。把每一次数据处理都沉淀成可复用的脚本,等于把「每次的变动成本」转换成「一次性的固定成本」,这是三条路线里唯一成本随次数递减的做法。
四、喂指标,不喂明细。同样一份月结,全量明细约13.5万token,汇总指标只有两千字符量级,差约两个数量级。让模型碰该碰的部分——理解需求、组织成文;让脚本碰不该碰的部分——逐行读数、逐行计算。
五、交付物决定工具价值。评价一个表格工具,别只看它算得对不对,先看它交出来的是什么。能改的Word和PPT是交付物,截图只是预览。
4.2 三条避坑清单
- 汇总行陷阱:业务系统导出表常在表尾带「总计」行,合并求和前必剔,否则合计虚高一倍。判断依据很简单——分类列为空、名称以「总计」开头、金额恰好等于全表合计。
- 多文件不等于多月数据:本案例两份月表内容完全一致。合并前先做重复行检测,重复率接近100%就要回头查数据源,而不是继续往下算。
- 零销量行会稀释所有比例:本案例61.6%的明细行销量为零。做动销率、单品贡献、平均数之前,先明确分母是全量明细还是有动销记录。
4.3 可以本周就做的动作
如果你是数据分析师:把手头重复次数最多的那张表,写成一页口径说明——每个字段的含义、需要剔除的行、汇总层级、输出格式。这页纸就是脚本化的全部前置条件,写完它,你才有资格谈自动化。
如果你是财务:把「含税还是不含税」「从哪张表取数」「保留几位小数」写进语义定义一次。之后每次跑数,不用再向任何人解释口径,也不必担心新同事理解错。
如果你是运营或供应链:下次月结前,先把上个月的表丢进去跑一次体检,看看有几个汇总行、多少重复行、多少零销量行。这三个数字大概率会让你重新审视过去一年的报表。
如果你是管理者:评估这类工具时只问三个问题——第二次处理还收费吗?处理脚本存在哪、能不能审计?明细数据有没有离开过你的机器?三个答案都令人满意,再谈价格。
4.4 这个案例不适用的情况
诚实的案例研究要写清边界。以下情况,本案例的跑法不适用:
- 输入以PDF、图片、Word原文件为主——这类工具目前只吃xlsx和CSV,源文件需要先转成表格。
- 核心诉求是多人协同与版本追溯——本地工具擅长个人与小组的重复型报表,不擅长替代协同平台。
- 需要接实时数据源——它处理的是已有表格,不是业务系统的实时流水。
- 指望全程断网出报告——处理动作可断网复用,报告成文需要联网调用模型接口,这是产品形态决定的,不是设置问题。
小结
这个案例最有意思的地方,不是工具把4小时压到了10分钟,而是它在汇总之前拦下了三个足以让报告作废的陷阱:一条混在明细里的总计行、两份一模一样的「不同月份」的表、一群被当成销售记录的商品主数据。省时间只是收益的可见部分,省掉「在脏数据上得出自信结论」的机会成本,才是大头。
对每一个每月都在做同类汇总的人来说,可迁移的做法只有一句话:第一次把口径、规则、脚本固化下来,之后每一次都只换数据。数据文件在本机处理、脚本固化后本机复用不再消耗调用量、报告成文时只喂汇总指标——以数以轻舟Agent为载体的这套路线,把大模型的理解能力用在了刀刃上,把重复劳动留给了本机脚本。
参考资料:
· 《网络数据安全管理条例》(国务院令第790号,中国政府网):2025年1月1日起施行
· 中国信息通信研究院《大模型专有云服务市场分析报告》:82%企业倾向私有化部署、API均价降幅口径
· Harvard Business Review: Data Scientist, The Sexiest Job of the 21st Century:数据分析师约80%时间用于准备数据的调研口径
· Panko, R.《What We Know About Spreadsheet Errors》:35年电子表格错误率综述,约94%的电子表格存在错误
· 第三方模型价格统计(TokenMix口径):高能力模型每百万输出token中位价25美元至2.8美元
· 本案例原始数据:某调味品供应链公司8月、9月商品销售统计表(文中全部实跑数字可由原始文件复算)
立即体验数以轻舟Agent
本地安装 · 终身买断 · 数据本地处理。说人话做表,不写代码、不写公式。