一提「用AI处理公司数据」,很多人第一反应是:要不要把大模型私有化部署回本地机房?好像模型不在自己服务器上跑,数据就一定会泄露。这个直觉可以理解,但它把两件事混在了一起——模型跑在哪儿,和数据在哪儿被看见、被留存、被谁经手,并不是一回事。
事实是,绝大多数中小企业既养不起「把大模型私有化部署回本地」的代价(一张够用的推理显卡就要六位数,还要配套运维、版本迭代、安全加固),也不一定需要走到那一步。数据安全的本质,不是「模型在不在本地」,而是你能不能控制数据流向、把敏感信息最小化、并对每一次调用留痕。下面拆五层做法,不依赖本地部署,也能把风险压到可控范围。
本文要点
- 误区先拆:本地部署 ≠ 数据安全,上云 ≠ 数据裸奔;焦虑该从「模型在哪」挪到「数据去哪、怎么去、留什么痕」。
- 五层做法:字段脱敏 → 本地预处理只传必要结果 → 选企业级合规模型接口 → 权限与留痕 → 把分析逻辑固化成确定性脚本减少模型调用。
- 落地组合:数据本地处理、不进第三方 SaaS 聊天框,成文出报告时才调用你自选的合规大模型接口;常用分析逻辑固化成可复用的本地脚本。
- 边界清晰:报表清洗、经营分析、内部月报等用「脱敏+本地预处理+合规接口+权限留痕+逻辑固化」已足够;只有核心机密或监管强要求数据不出域,才值得投入本地部署。
- 给负责人:一张行动清单——数据分级、强制脱敏、只用企业版接口留审计、高频分析脚本化、定期复盘权限与日志。
一、先拆一个误区:本地部署不等于数据安全,上云也不等于数据裸奔
把模型搬回本地,确实能让「推理」这一步不出机房。但它解决不了另外两个更常见的问题:一是本地团队未必比云厂商更懂安全加固,二是数据风险的大头往往在「人」和「流程」——比如员工把客户名单直接粘贴进公用的网页对话框,这种泄露跟模型在哪跑毫无关系。
反过来,主流大模型厂商的企业版(如 Azure OpenAI、阿里百炼企业版、火山引擎等)普遍提供「数据不用于训练」「租户隔离」「可调用的私有通道」承诺,配合合同与等保合规,数据并不等于「裸奔」。所以第一步,是把焦虑从「模型在哪」挪到「数据去哪、怎么去、留什么痕」。
二、不部署本地模型,也能守住数据的五层做法
- 字段级脱敏,送模型前先打码。姓名、手机号、身份证、具体金额这些字段,在送进模型前先做脱敏或泛化:手机号中间四位掩码、金额只留区间、姓名用编号替代。模型看到的是脱敏后的样本,拿不到能直接定位到人的原始信息。这一步在本地就能完成,不需要模型参与。
- 本地预处理,只传必要结果。不要在原始明细表上直接操作,也不要把整张表丢给模型。正确做法是:原始数据留在本地工作区,用本地脚本先把清洗、聚合、统计做完,只把必要的结论或脱敏后的片段发给模型去生成文字或报告。原始明细始终不离开你的电脑。
- 选企业级、合规的模型接口。对接大模型时优先选企业版或商用接口,确认三点:数据是否用于训练、是否有租户隔离、能否走企业私有通道与审计日志。不同厂商政策不同,接入前把条款看清楚,比盲目追求「本地」更实在。
- 权限与留痕,谁经手谁负责。给数据分级别,谁能看明细、谁能看脱敏版、谁能调用模型,分开授权;每一次调用留审计日志。再安全的通道,没有权限边界也会出事。
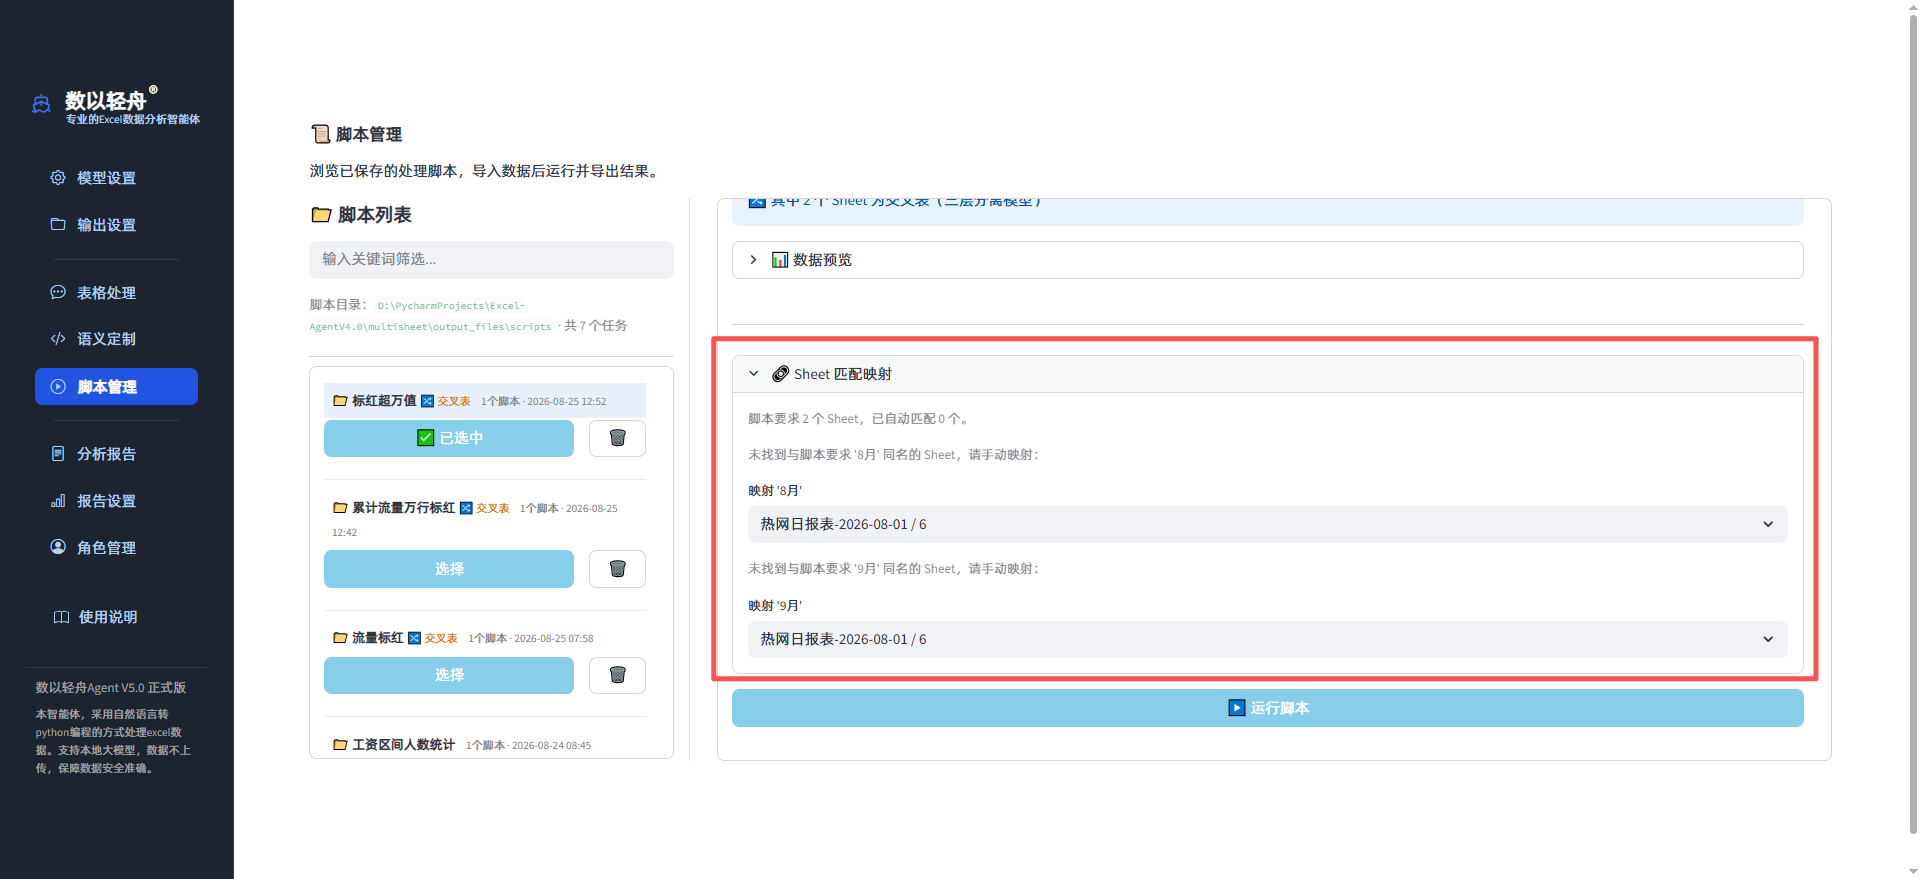
- 把分析逻辑固化成确定性脚本,减少模型调用。很多「反复让AI算」的场景,其实第一次用模型把分析流程搭好、验证无误后,就可以固化成一段本地确定性脚本,以后同口径的数据直接跑脚本,不必每次都把数据喂给模型。调用次数降下来,数据出域的机会自然也少——这是比「本地部署大模型」更轻、落地更快的解法。
三、一个可落地的组合:本地处理数据 + 多模型接口
把上面几层拼起来,一种务实的架构是:数据文件在本地处理、不进第三方 SaaS 的聊天框,需要成文或出报告时,再调用你自选的合规大模型接口;同时把常用的分析逻辑固化成可复用的本地脚本。
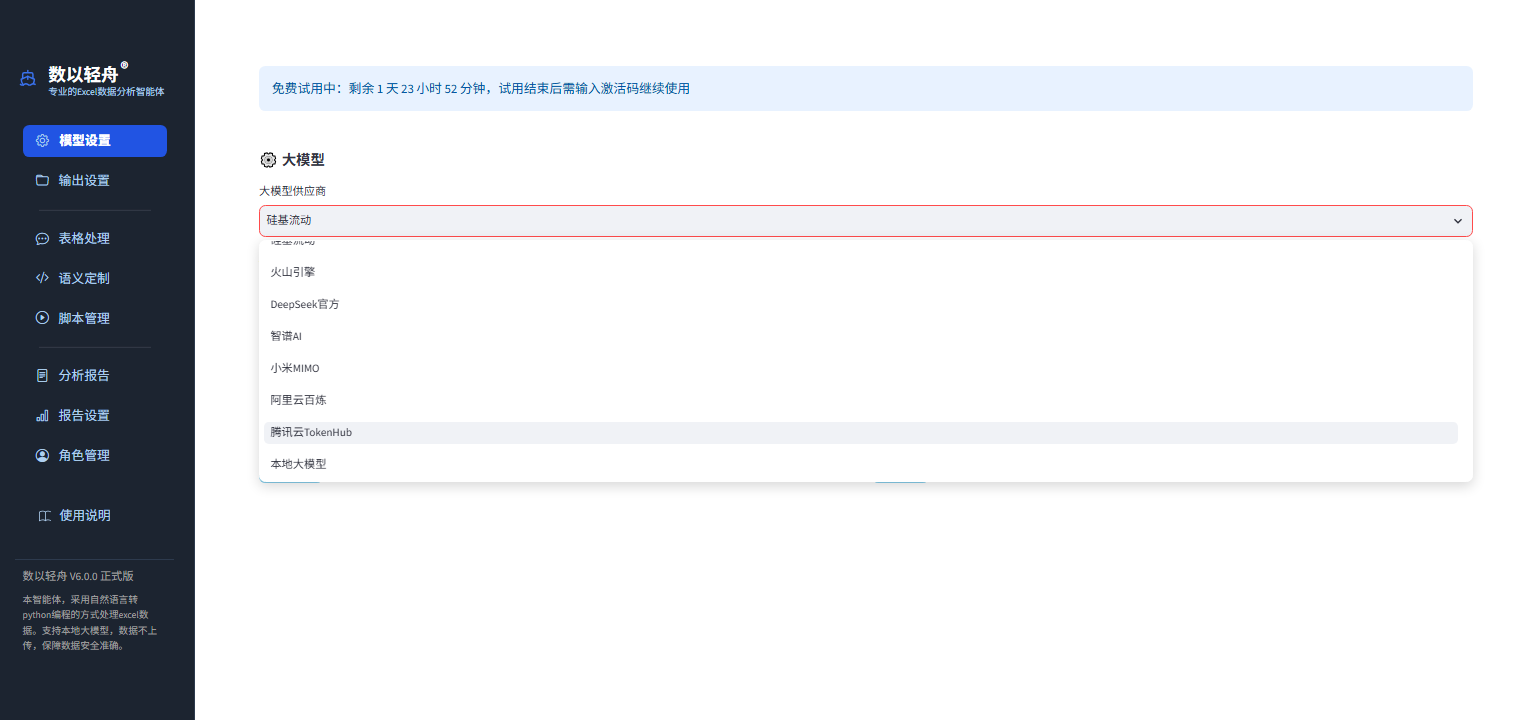
以 数以轻舟 为例:它把 Excel 与 CSV 的清洗、统计、报告生成放在本地完成,原始数据不进聊天框、不传第三方 SaaS;模型调用走多种可接入的大模型接口(智谱 AI、DeepSeek、火山引擎、阿里百炼等,不绑定单一默认模型),由用户自己配置算力;而一旦分析流程被验证,就能保存为本地脚本,下次同口径报表断网也能复用。它不宣称自己「内置本地部署的大模型」,而是把安全边界放在「数据在本地处理、调用可控、逻辑可固化」上。
四、什么情况可以不上本地模型,什么情况最好上
- 可以不上本地模型:报表清洗、经营分析、内部月报、脱敏后的样本分析——这类场景用「本地预处理 + 企业接口 + 脱敏 + 留痕」已经足够,性价比远高于自建机房。配合本地安装的数据工具(如 数以轻舟)做预处理,再走企业接口成文,是大多数企业更划算的选择。
- 建议本地或私有化部署:涉及核心机密、监管强要求数据不出域(如部分军工、政务涉密场景),或合规条款明确要求推理不出域的,才值得投入本地部署的算力与运维成本。
一句话:先用「脱敏 + 本地预处理 + 合规接口 + 权限留痕 + 逻辑固化」把风险压下来,真到合规红线再考虑本地部署,不要一步到位背上沉重包袱。
五、给负责人的一张行动清单
- 列一张数据分级表:哪些字段绝对不能出域,哪些可以脱敏后使用。
- 任何送模型的步骤,强制先过脱敏或聚合。
- 模型接口只用企业版,留存合同与审计日志。
- 把高频分析固化成本地脚本,减少模型调用次数。
- 定期复盘权限与日志,而不是一次性配完就忘。
数据安全没有「一招鲜」,但也不等于「非得把大模型搬回家」。把流向管住、把敏感信息最小化、把逻辑固化下来,不上本地模型,数据同样能守得住。
软收尾
当「本地部署大模型」被当成数据安全的唯一解,很多中小企业反而被挡在了门外。真正稳的,不是某一种部署形态,而是你手里那套能管住流向、能最小化敏感信息、能把逻辑固化下来的能力。
参考资料:
· 中华人民共和国中央人民政府:《中华人民共和国数据安全法》(2021 年 9 月 1 日起施行),明确数据处理活动的安全保护义务与分类分级要求。
· 中华人民共和国中央人民政府:《中华人民共和国个人信息保护法》(2021 年 11 月 1 日起施行),规范个人信息的处理、脱敏与跨境提供规则。
· 全国信息安全标准化技术委员会(TC260):发布 GB/T 22239《信息安全技术 网络安全等级保护基本要求》等网络安全等级保护(等保 2.0)相关标准。
本文由 AI 辅助生成,经人工审核。
更多数据实战与行业观察
数据本地处理、口径可固化、逻辑可复用。前往文章中心,查看完整的销售、库存、财务、HR 实战案例与行业分析合集。