本文要点
- 会聊天 ≠ 会分析:判断一个模型数据分析能力强不强,核心看它能不能"跑代码、拿真结果",而不是凭语感猜答案。
- 四大能力支柱:代码执行、长上下文、推理能力、多模态理解,叠在一起才构成可靠的分析能力。
- 国产阵营各有侧重:DeepSeek、Qwen 开源强且成本低;Kimi 长上下文;智谱、文心中文与推理强;豆包多模态便宜;混元、星火本地化与语音见长。
- 选型看四点:是否支持代码执行、上下文够不够大、能否本地化保护数据、成本怎么算。
- 没有"唯一最强",只有"最适合这笔活":先想清数据量、问题复杂度、答案重要性,再对号入座。
开场白:先给结论
现在很多 AI 不只陪你聊天,还能真的"帮你算数据":上传一份 Excel,让它找出销量下滑的原因;丢给它一堆实验记录,让它画出趋势。但不同 AI 在数据分析上的本事差别很大——有的能给你算出真结果,有的却会一本正经地"编数字"。一句话结论:数据分析能力强的 AI,不是"嘴上会说",而是"能跑程序、拿真数、讲清所以然"。这篇文章用大白话讲清楚:什么样的模型才算数据分析能力强,目前主流有哪些,以及普通人该怎么选。
一、定义:什么是"数据分析能力强的 AI 模型"
定义 数据分析能力强的 AI 模型,是指那些不只"凭印象回答",而是能真正读懂数据、处理数据、发现规律、并把结论讲明白的模型。
它需要完成四件环环相扣的事:
- 读懂——理解你的问题和数据:表格里每一列是什么意思、哪些是关键字段。
- 处理——清洗、合并、计算:把几张表拼起来、算同比增长、做分组统计。
- 发现——从数字里看出门道:哪里异常、趋势如何、哪些因素相关。
- 讲清——把结果变成图表和一段人话,告诉你"所以呢,接下来该怎么办"。
打个比方:它像一位"全能数据分析师"。普通聊天 AI 像背书很快的实习生,嘴上说得头头是道,数字却可能算错;而数据分析能力强的模型,相当于既懂业务提问、又会亲手写代码取数、还能画图讲故事的资深分析师。
关键区分 会聊天 ≠ 会分析。有些模型文笔好、很能聊,但一遇到真实表格就容易"编数字"。判断一个模型是否擅长分析,核心看它能不能"跑代码、拿真结果",而不是"凭语感猜答案"。
二、详细解释:这些模型到底强在哪里
1. 四大能力支柱
一个模型的数据分析能力,大体由四根"柱子"决定(见下图)。它们并非彼此独立,而是叠在一起,才构成"可靠的分析能力"。
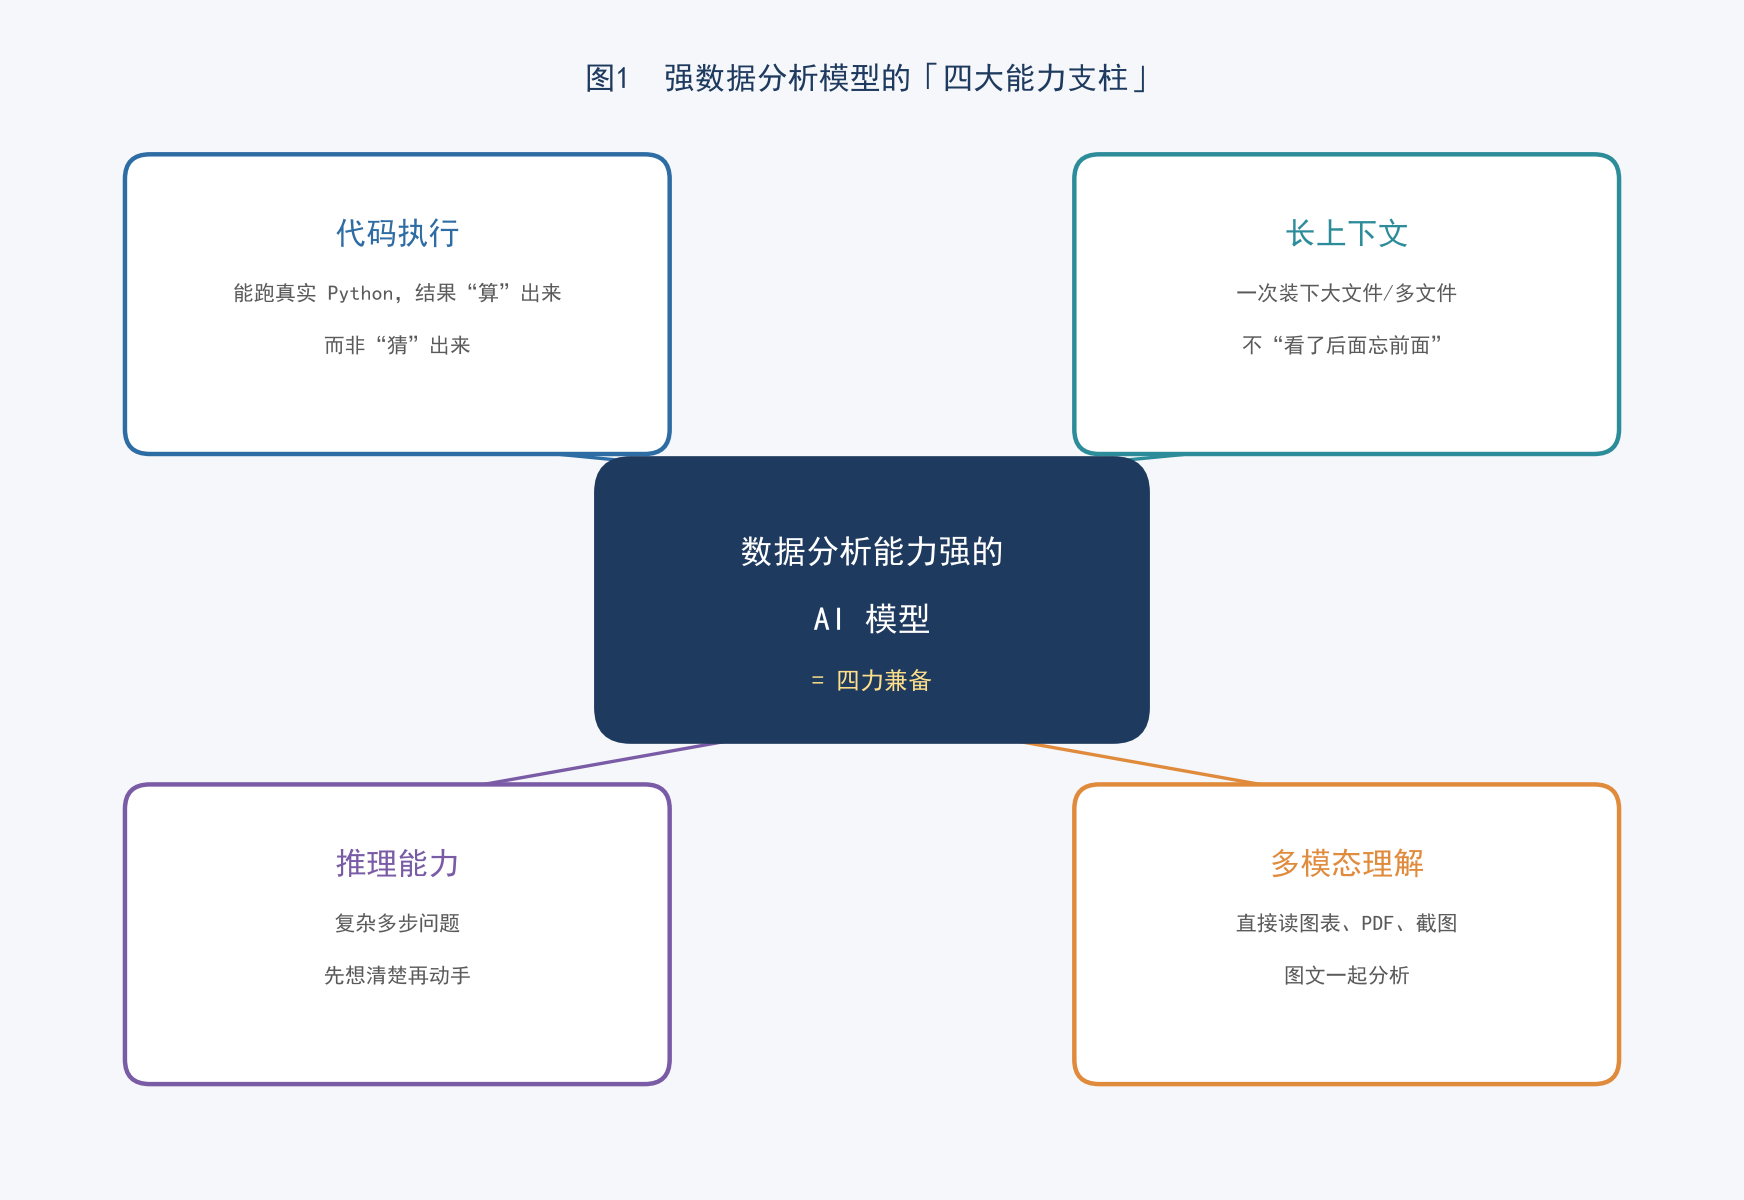
- 代码执行能力(代码解释器 / 工具调用):这是最关键的一根。模型能在一个真实的 Python 环境里自己写代码、运行代码,用 pandas 处理表格、用 matplotlib 画图。结果是由程序"算"出来的,而不是模型"猜"出来的,这从根子上避免了胡编数字。
- 长上下文:能一次"装下"很大一份数据或多个文件。上下文窗口越大,它越像记忆力超好的助理,不会看了后面忘了前面。
- 推理能力(思考 / 推理模式):面对复杂、多步骤的问题(比如"先按地区分组,再检验差异是否显著"),它会一步步想清楚再动手,而不是脱口而出。
- 多模态理解:能直接读图表、PDF、截图,甚至把"看一张图"和"读一张表"结合起来分析。
2. 国内主流模型有哪些
先看一次分析任务是怎么跑起来的(见文末"协作流程"图),再对照下面的分类来理解不同模型的差异。按"能力特征"来看,目前国内主流模型大致分成以下几类,各有擅长的方向(本文聚焦国产模型):
| 模型家族 | 在数据场景里的强项 | 更适合谁 |
|---|---|---|
| 深度求索 DeepSeek | 开源、推理能力强、训练与调用成本低,官方及第三方平台都支持代码执行 | 预算敏感、想自托管、希望自己掌控模型的用户 |
| 阿里通义千问 Qwen(含 Qwen-Code) | 开源生态最活跃,中文与代码兼顾,函数 / 工具调用成熟 | 中文场景、要在自有系统里二次开发的团队 |
| 月之暗面 Kimi | 超长上下文见长,可"读完"长报告 / 长表格,长文档分析友好 | 长文档、长对话式的分析 |
| 智谱 GLM(ChatGLM / Z1 推理) | 中文与推理都强,智谱清言等产品内置代码解释器与数据分析 | 需要严谨推理、又想中文无障碍沟通的分析 |
| 字节豆包 Doubao(火山引擎) | 多模态、长上下文、调用便宜,企业侧经火山引擎接入 | 量大、成本敏感、要图文混合的企业应用 |
| 百度文心一言 ERNIE | 工具调用与代码解释器完备,中文理解积淀深 | 已用百度生态、要稳定中文服务的团队 |
| 腾讯混元 Hunyuan | 开源可自部署,代码与多模态兼顾 | 重视数据本地化、腾讯技术栈的团队 |
| 讯飞星火 Spark | 中文与语音场景强,适合边问边算 | 教育、语音交互类分析场景 |
提醒 国内各家版本号与产品名更新极快(如 Qwen、GLM、Kimi 等半年就可能换一代)。上面讲的是"家族与能力特征",具体型号与是否开放代码执行,以各厂商官网为准——选模型时看"能力特征",比死盯版本号更靠谱。
除了模型本身,还可以借助"专用数据分析工具"(也叫数据分析 Agent,例如面向非技术用户的对话式分析产品)——它们把模型包在现成的取数、画图流程里,门槛更低;但涉及关键结论时,仍建议人工复核。
三、相关概念(看懂这几个词就够用)
- 大语言模型(LLM):能理解和生成自然语言的 AI 底座,"数据分析能力"是它在上边长出来的一项技能。
- 代码解释器 / 工具调用(Code Interpreter / Tool Use):让模型能调用外部工具(如运行 Python、查询数据库)的能力,是"算真结果"的关键开关。
- 智能体(Agent):能自主规划、连续调用多个工具完成多步任务的 AI。数据分析 Agent 就像一位"自动分析师":自己取数、清洗、画图、写报告。
- 检索增强(RAG):先去查资料或文档再回答,减少凭空编造,常用于"基于公司文档做分析"。
- 微调 vs 提示词:微调是拿特定数据重新训练模型;提示词是给现成模型写好指令。多数普通人用"提示词 + 代码解释器"就足够了。
- 传统 BI vs AI 分析:传统 BI(如 Power BI、Tableau)要人先搭好看板;AI 分析用自然语言直接问,门槛更低。严谨的正式报表,建议两者结合。
四、应用场景
- 经营分析:上传销售 / 库存表,让它找增长点、预警滞销商品。
- 科研与实验:处理成百上千条记录,做统计检验、画趋势图。
- 金融与风控:核对账目、做敏感性分析——越是重要的结论,越要复核。
- 运营与用户研究:分析问卷、工单,提炼用户痛点。
- 个人日常:整理一年账单,把杂乱的表格变成清晰图表。
五、怎么选?一张自检清单
- 是否支持代码执行 / 数据分析工具?——没有它,数字可能不靠谱。
- 上下文够不够大?——数据量大,就选长上下文模型。
- 是否开源可自托管?——重视数据隐私,就选能在本地跑的开源模型。
- 中文(或你常用语言)支持好不好?
- 成本如何?——日常随便用选免费或低价,关键分析再上高端模型。
一句话总结:没有"唯一最强"的模型,只有"最适合你这一笔活"的模型。先想清楚你的数据有多大、问题有多复杂、答案有多重要,再拿上面的清单对号入座。
数据合规提醒 如果你的数据涉及客户名单、薪酬、流水等敏感信息,须遵守《数据安全法》《个人信息保护法》等要求,优先选择数据本地处理的方案;涉及数据要素流通与治理的权威动态,可关注国家数据局发布的相关政策。把"数据在哪处理"想清楚,比纠结模型名气更关键。
六、一次分析的完整链路(协作流程)
把前面几块拼起来,一次 AI 数据分析任务通常是这样跑起来的:你用自然语言提需求 → 模型把需求翻译成可执行的脚本 → 脚本在真实环境里读表、清洗、计算 → 再把结果组织成图表与结论。下面这张图把这条链路画清楚。
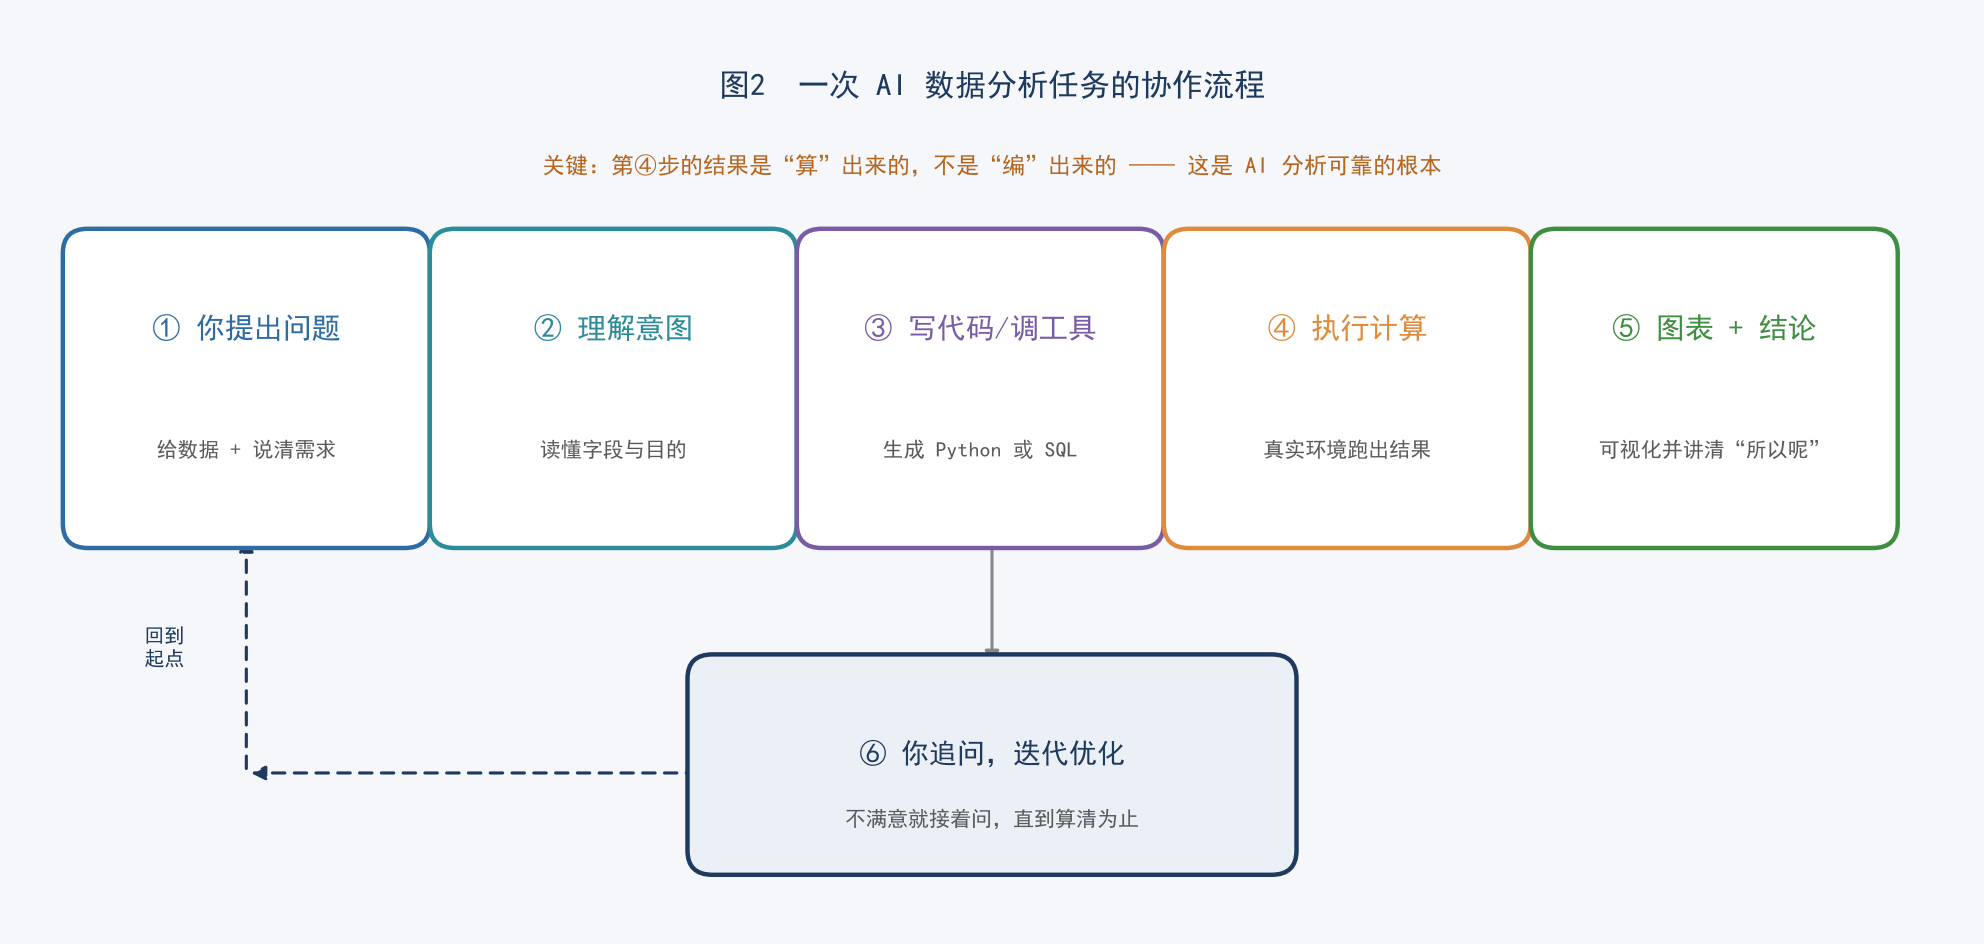
这里有个容易被忽略的细节:真正"算数"的那一步在脚本执行环境里,而不在对话框里。所以当你用本地化的数据处理智能体(例如数以轻舟Agent)时,数据文件在本地处理,不进聊天框、不传第三方 SaaS,分析逻辑还能沉淀成可复用脚本——数据的"算"和"留"都在你自己的电脑上,这比把整张表丢进公网对话框更稳。它不绑定单一默认模型,可接入 DeepSeek、Qwen、Kimi、智谱等多种大模型接口,按这笔活的复杂度自行选择。
七、延伸阅读与参考(按名称)
- 各模型官方站点(以官网为准):DeepSeek、通义千问 Qwen、Kimi、智谱 GLM、豆包、文心一言、腾讯混元、讯飞星火。
- 数据治理与合规:国家数据局,以及《数据安全法》《个人信息保护法》相关条文(详见 中国政府网)。
- 概念科普:关于"代码解释器""大语言模型""检索增强生成(RAG)"等,可查阅官方文档与科普文章;看第三方评测时,优先选"用真实文件、结果可验证"的榜单,而不要只看跑分数字。
说到底,AI 帮你算数据,靠的不是"会聊天",而是"会跑程序、拿真结果"。把模型的能力特征和你的数据、问题、成本对上号,选型就不慌了。
本文由 AI 辅助生成,经人工审核。