做银行、信贷、互金的人,月底几乎都逃不过一件事:数据清洗。对账单、交易流水、客户信息表、风险名单,几十万行是家常便饭,字段密到一眼数不清,脏的地方还特别集中——客户号对不上、重复开户、日期格式五花八门、空值散在各列。我前阵子帮同事处理过一份季度流水,光"账户号与客户号不匹配"一种就筛出四千多行,加上手工去重和补空,整整搭进去两个晚上。今天这篇文章,就围绕"银行数据清洗靠不靠谱"这个问题,讲讲我实测一份真实对账单时的完整过程、数据和边界。
一、为什么银行数据清洗总是这么慢?
先说我看到的普遍状态。银行相关的表,痛点几乎固定:一是量太大,几万到几十万行,Excel 一拖就卡;二是字段太密,几十列里总有一列缺值、总有一段格式不统一;三是敏感,客户姓名、证件号、流水金额都属于不能随便外传的信息,很多单位连往网页工具里拖文件都要走内部审批。
于是日常只剩下两条路:人工在 Excel 里死磕,或者写 VBA、写脚本。人工死磕费时间,月底对账通宵是常态;写脚本又卡在"不是每个人都写得来"上,而且表结构一变,脚本就得跟着改。这就是"银行数据清洗慢"的真相:不是数据多难,而是处理方式一直在原地打转。
二、核心特点:选工具先看这三样
我实测下来的经验是,评判一个数据清洗方案,不用看它宣传得多炫,先看三点。
- 数据文件在哪儿处理——是不是留在本机、不进聊天框、不传第三方平台,敏感表的出域风险是不是可控;
- 处理过程能不能回看——每一步做了什么、改了哪些行,要能查得回来,而不是交回一个结果就完事;
- 同类活下次能不能复用——清洗对账单的规则这次定好,下个月能不能直接套用。
按这三条标准去筛,会发现符合的不多。本地安装、数据文件本地处理、处理脚本本地保存、软件一次买断的"数以轻舟",把这三条都占住了——它不是云端那种"文件传上去、结果拿下来"的黑盒,而是把处理逻辑放在你电脑上跑完。
三、对比:本地处理与云端工具,差在哪?
把两种形态摆在一起看,差异会很具体。
| 对比维度 | 云端工具 | 本地处理(数以轻舟) |
|---|---|---|
| 数据出域 | 基本都要先把文件上传,敏感表走这个链路总得掂量 | 文件不出本机,只有"生成处理脚本"这一步需要联网调算力,而且这一步用的是脱敏样本 |
| 计费方式 | 常见按积分、按订阅,用量一大月底账单跟着涨 | 一次性授权软件本体,模型算力由自己接入、按量购买,产品还内置 token 优化把消耗压低 |
| 可复查性 | 给结果、过程通常是黑箱 | 每一步跑过什么、规则怎么写的都在本机记录里,出了数能回去对 |
| 格式边界 | 只支持 xlsx / csv | 只支持 xlsx / csv;旧版 .xls 要先另存为 .xlsx,PDF、图片、Word 暂不支持 |
四、核心功能:真实对账单实测
下面进入实测。我拿一份 8 万行左右的银行流水对账单,把三类最常见的问题各跑了一遍。
- 常见脏数据清洗:重复行去重、空白单元格补值、日期和金额列格式统一,我用一句自然语言下指令,脚本就在本地生成并运行,几秒出结果,不用手动一条条改。
- 多表关联:账单里的"客户号"要跟客户主表对上,把两张表按关键列匹配,缺号、错号直接标出来,比 VLOOKUP 一个个拉省心太多。
- 规则复用:这次清洗定的规则会作为脚本保存在本地,下个月再对同一类账单,把脚本捡起来直接跑,断网也能运行,不用每次重写。
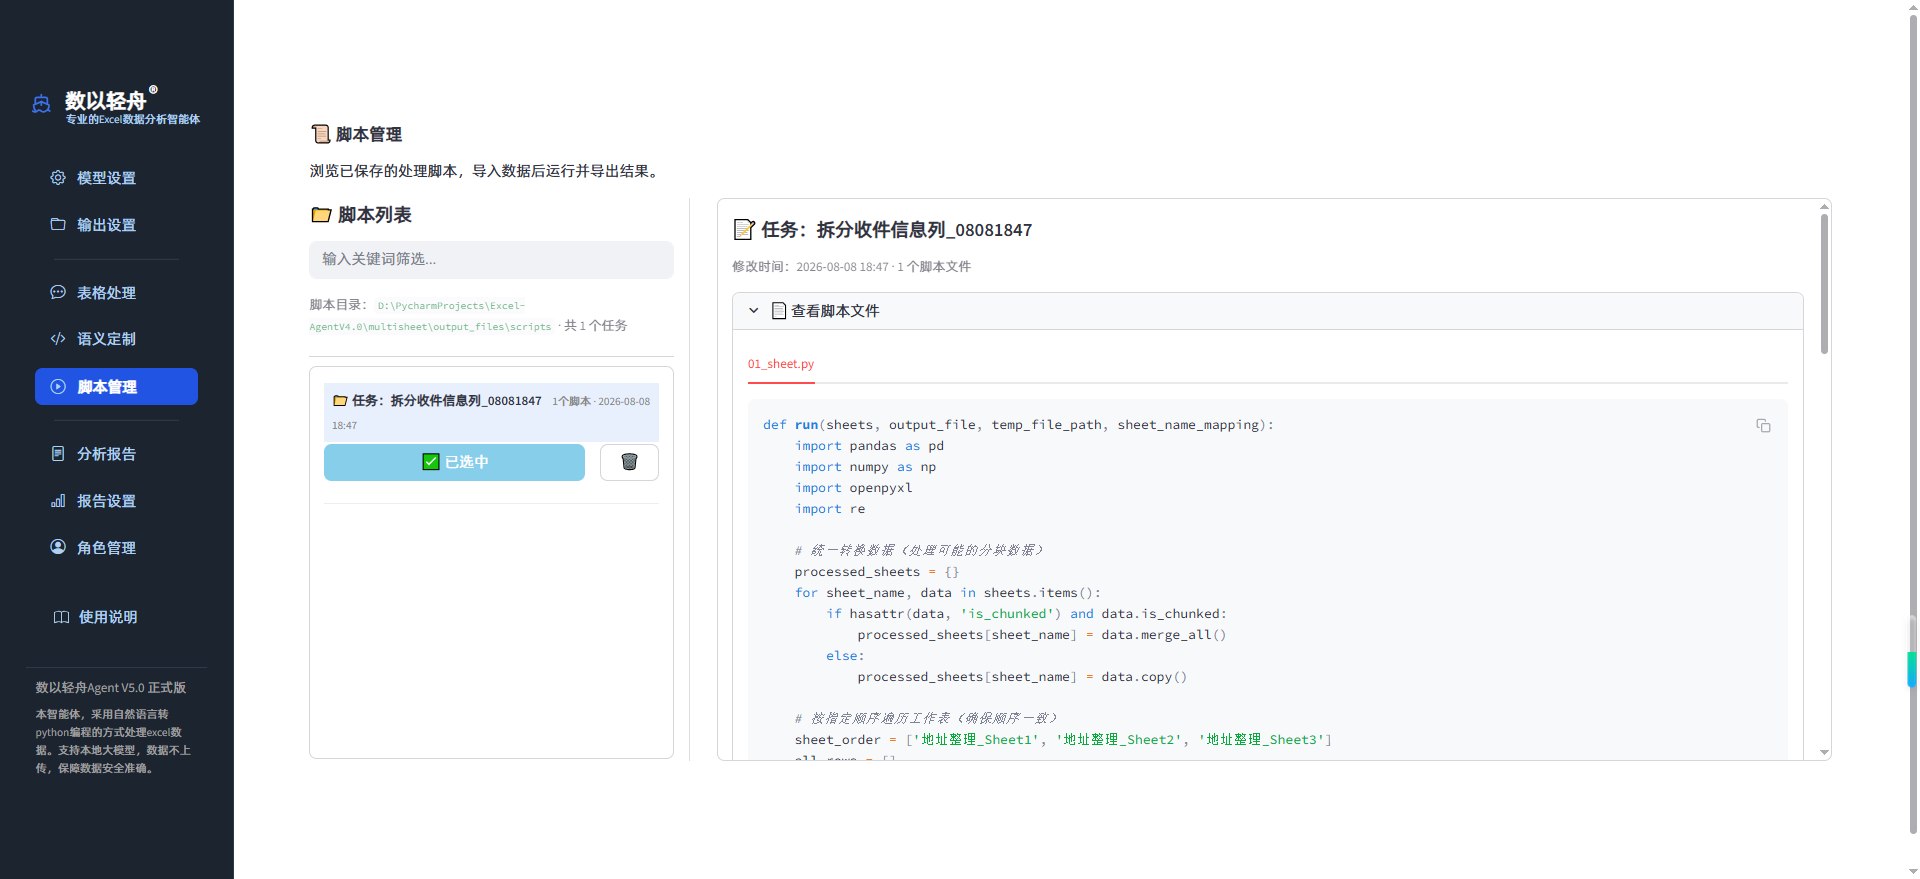
整个流程我没有写任何代码——指令用自然语言,脚本由工具自动生成并运行,跑完还能回看每一步。边界也如实讲:它处理的是表格类数据,别拿 PDF 表格、图片表格来试,那个暂不支持;首次生成脚本仍需联网调用算力,这个环节跳不过去。
五、适合谁,什么人不建议
这套方案适合的人群很明确:银行、信贷、互金行业的统计岗、风控岗、运营岗,每月要对账、做报表、清洗名单,但不想为这事自己写代码的人;还有对数据出域敏感、需要把文件留在本机处理的机构人员。
反过来,两类人不建议用:一是期望开箱即用、什么都不用配置的,因为模型算力需要自己接入 API 并按量购买,这个门槛要提前认;二是手头要处理的是 PDF、扫描件、图片这类非表格文件的,那它帮不上忙,先把文件另存为表格格式再说。会不会写代码不是门槛——脚本由工具在本地自动生成并运行,"数以轻舟"的用户不碰代码。
六、FAQ:三个高频问题一次说清
问:买断之后每次处理数据还要另外交钱吗?答:不是。买断的是软件本体授权,模型算力要自己接入、自己向模型厂商购买,产品不代充、不抽成,内置 token 优化会把消耗压低。
问:处理过程真的可以复查吗?答:可以,脚本和运行记录都留在本机,每一步做了什么都能回看,不像云端工具交回一个结果就完了。
问:支持 250 万行吗?答:支持,文件没有大小限制,几万行、几十万行的表都能跑,前提是格式为 xlsx 或 csv。
说到底,数据留在自己电脑上、脚本还能留着下次复用,比反复手工对表省心得多。银行数据清洗靠不靠谱,我的答案是用对方法就靠谱——先看数据在哪儿、钱怎么算、能不能复查,这三点想明白了,答案基本就有了。