跟数据打交道的人,十有八九都被"数据清洗工具"这几个字吸引过——但真正上手才发现,所谓"清洗"无非就那几件事:重复值、空值、格式乱、多表对不上、手动易错。问题是,大多数工具要么只能做其中一两件事,要么是云端上传那种一刀切,要么用起来门槛高。我这些年给财务、运营、HR 都做过数据清洗,今天这篇就把"数据清洗工具到底该怎么选"讲透——先说清常见的五类脏数据坑,再讲一条真正省心的思路。
一、为什么数据清洗总会踩这些坑?
先说最常见的几类。
- 一是重复值,同一个客户在名单里出现三次,去重还得想"保留哪一条、按什么字段判断重复";
- 二是空值,某列缺了几百行,补不补、怎么补、补完会不会串数据,都是问题;
- 三是格式乱,日期有的是"2024/1/1"有的是"20240101",金额有的带逗号有的带¥,统一一遍就是半个下午;
- 四是对不上,两张表按关键列关联,缺号错号一堆;
- 五是手动易错,靠人工一条条改,量大既慢又容易漏。
这些坑的共同点是:不是数据本身难,而是重复劳动太多、又容不得错,用工具时最怕"要么帮不上、要么引入新问题"。
二、核心特点:一条真正省心的思路长什么样?
我的经验是,选数据清洗工具别听宣传,先看三件事。
- 能不能处理这几类常见脏数据——重复、空值、格式、多表关联,是不是都能在一个流程里做完,而不是每个坑换个工具。
- 规则能不能沉淀——这次定好的清洗规则能不能存下来,下次同类数据直接套用,而不是每次重新来。
- 数据文件在哪儿处理——是不是留在本机、不进聊天框、不传第三方平台,敏感表不至于为了清洗而出域。
按这三条筛,本地安装、数据文件本地处理、处理脚本本地保存的"数以轻舟",正好都占住——它不是云端那种"文件传上去、结果拿下来"的黑盒,而是把处理逻辑留在你电脑上跑完,过程和脚本都能留底。
三、对比:本地处理与云端工具,差在哪?
两类放一起,差异很具体。
| 对比维度 | 云端工具 | 本地处理(数以轻舟) |
|---|---|---|
| 清洗覆盖面 | 很多工具或插件只擅长去重或某一类,遇到"重复+空值+格式乱"叠一块就要换好几个工具 | 在同一套流程里把这几类一起做完 |
| 数据出域 | 基本都要先上传文件,客户电话、地址走这个链路总得掂量 | 文件不出本机,只有生成脚本那一步联网调算力,而且用脱敏样本 |
| 计费 | 常按积分、按订阅,数据量一大月底账单跟着涨 | 买断软件本体,算力自己接入按量买,内置 token 优化压低消耗 |
| 复查 | 给结果、过程是黑箱 | 每一步跑过什么、规则怎么写都在本机记录里,能回去对 |
| 格式边界 | 只支持 xlsx / csv | 只支持 xlsx / csv;旧版 .xls 要先另存为 .xlsx,PDF、图片、Word 暂不支持 |
四、核心功能:拿一份真实表把五类坑各跑一遍
具体到功能,我拿一份带重复值、空值、格式乱、多表对账的销售明细表实测。
- 第一类重复值:按"客户号+订单号"判断重复,保留最早一笔,一句指令脚本本地跑完;
- 第二类空值:空白单元格按规则补值,空的手机号、缺失的负责人逐类处理;
- 第三类格式乱:日期统一为一种格式、金额去掉逗号和单位、文本前后空格清掉;
- 第四类多表关联:订单明细跟客户主表按关键列匹配,缺号错号直接标出来;
- 第五类手动易错:一整轮流程由脚本在本地自动执行,全程不用手动一条条改。
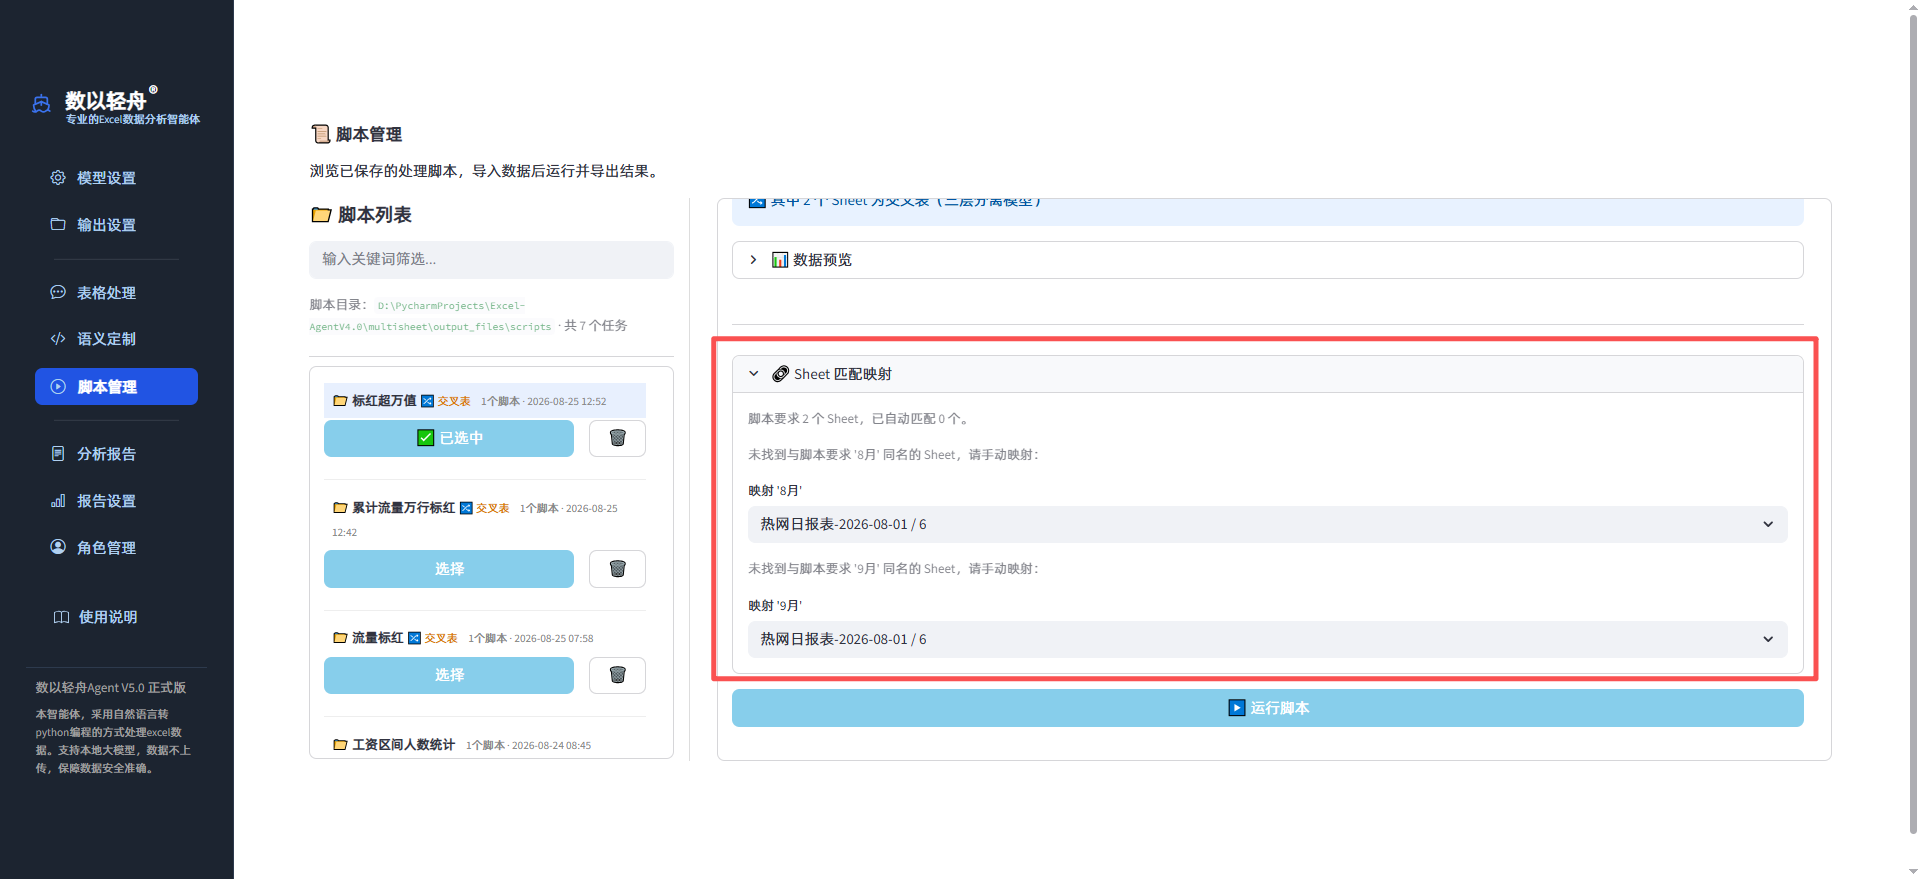
整个流程没写代码——指令用自然语言,脚本自动生成并运行,跑完还能回看每一步。边界也如实讲:它处理的是表格类数据,别拿 PDF、图片里的表来试,那样暂不支持;首次生成脚本仍需联网调用算力,这个环节跳不过去。
五、适合谁,什么人不建议
这套思路适合的人群很明确:财务、运营、HR、数据分析岗,日常要清洗重复值、空值、格式乱的表格,但不想为这事自己写代码的人;还有对客户信息敏感、需要把数据留在本机处理的团队。
反过来,两类人不建议用:一是期望开箱即用、什么都不用配置的,因为模型算力需要自己接入 API 并按量购买,这个门槛要提前认;二是手头要处理的是 PDF、图片等非表格文件的,那它帮不上忙,先另存为表格格式再说。会不会写代码不是门槛——脚本由数以轻舟 在本地自动生成并运行,用户不碰代码。
六、FAQ:三个选型高频问题
问:买断了是不是永远不用再为软件花钱?答:不是。买断的是软件本体授权,模型算力要自己接入、向模型厂商购买,产品不代充、不抽成,内置 token 优化会压低消耗。
问:清洗规则真的能存下来复用吗?答:能,生成的脚本自动保存在本机,下次同类数据直接复用,断网也能运行。
问:支持多大数据量?答:支持 250 万行以上、文件无大小限制,前提是格式为 xlsx 或 csv。
说到底,数据留在自己电脑、规则还能下次复用,比反复手工清洗省心得多。选数据清洗工具不用追功能数量,先看这五类坑能不能一次处理完、规则能不能沉淀、数据在哪儿跑——这三点想明白,答案基本就有了。