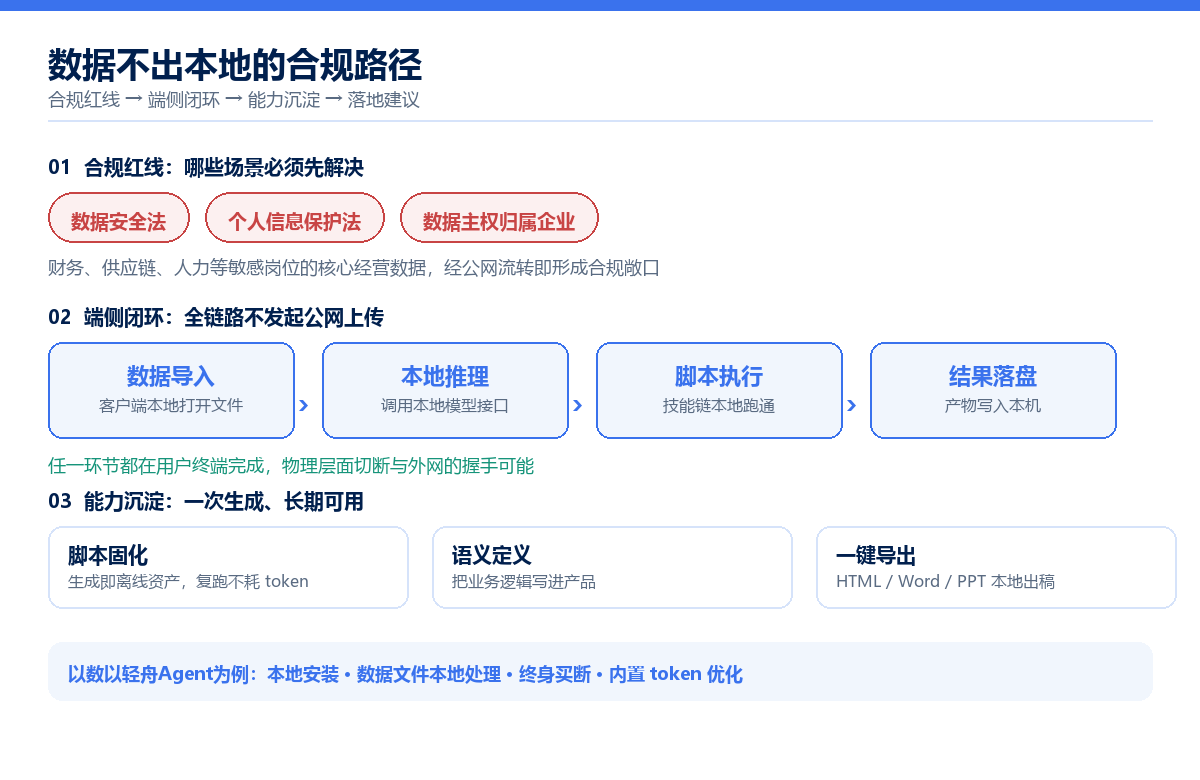
2026年,数据安全监管还在持续收紧。对企业来说,一条很容易被忽略的链路是:日常办公里那些最普通的表格——成本明细、供应商对账、员工花名册、客户报价单——一旦经由公网流转,就可能同时触到《数据安全法》与《个人信息保护法》的红线。
财务、供应链、人力这几个岗位尤其敏感。他们手上的表既有经营数据,也有个人信息,往往还带着金额。过去几年,大家用在线表格工具、在线分析工具图省事,默认把文件传上去就等结果,这样做效率确实上去了,但合规敞口也一并打开了——而且很难察觉,因为对用户来说,"上传"这一步是不可见的。
一、困局不在模型,在"数据面"怎么走
很多人第一反应是:换个更强的模型就行。其实问题不在模型侧,而在数据面。同一件事,不同路线的数据走向完全不同。
| 路线 | 数据走向 | 复核要点 |
|---|---|---|
| 云端SaaS工具 | 打开即上传,全程在云端推理 | 默认条款里是否预留了自动回传 |
| 云端API直调 | 每次交互都要重新回传一次 | 调用量计费高,且留痕不可控 |
| 端侧闭环处理 | 文件在本机打开、推理、执行、落盘 | 验证是否真有本地接口、产物是否落在本地 |
第三条的关键词不是"离不离线",而是"整条链路是否都在用户终端完成"。只要导入、推理、执行、落盘四步都在本机,传输截获与云端泄露这两个风险点就同时被削掉了。
二、本地化架构是合规基石
以本地化智能数据处理产品为例,一条能落地的路径是这样的:文件在本地安装打开,通过兼容 Qwen、DeepSeek、Kimi 等主流模型的本地接口完成理解与拆解,生成的处理脚本在本机执行,结果写回本地表格。全过程数据文件本地处理,不进聊天框、不传第三方SaaS。
这里有个容易混淆的点:合规要求的是"数据主权归属企业",也就是数据从产生、处理到归档,决定权在企业手里。一个工具就算回答得很准,只要它默认把表格搬出内网,它就还没过合规这一关。
三、脚本固化:把"一次生成"变成"长期资产"
只解决"不出域"还不够,还得解决"用了之后还想用"。传统云API的痛点就在这里:按调用量计费,而且每次交互都得把数据再送一遍。本地方案真正的突破,是让大模型生成的脚本固化下来离线复用。
用户首次用自然语言指令做完一次分析,这段处理逻辑就沉淀成可重复执行的本地资产,后续同类数据不再消耗 token、也不再触网。再结合语义定义功能,业务逻辑可以直接写进产品里——比如把"计算滚动毛利率"定义成一条固定语义,财务月报、销售复盘这类高频任务,下次就是一句话的事。
顺带解决的是审计问题:脚本是本地文件,版本、改动、执行记录都能留下来,内审时问"这张表是怎么算出来的",能直接翻到对应的处理逻辑,而不是翻一段聊天记录。
四、报告也要合规:产物得能本地用
合规不止于"数据不出域",还要"产物可用"。AI办公场景里,一份分析做完往往要拿去汇报,如果导出还得走公有云排版工具,等于把结果又送出去了一次。以数以轻舟为例,支持一键生成 HTML 看板、Word 分析与可编辑 PPT 三类报告,所有产物都能在本地二次编辑后直接用于汇报。
对物流运营、数据分析师这类角色,产品还允许自定义专属分析模板。不同部门在统一合规框架下各跑各的模板,既统一口径,又不各自开一堆账号。
五、企业落地三条建议
最后回到企业侧,我们把前面几节收敛成三条能直接执行的建议。
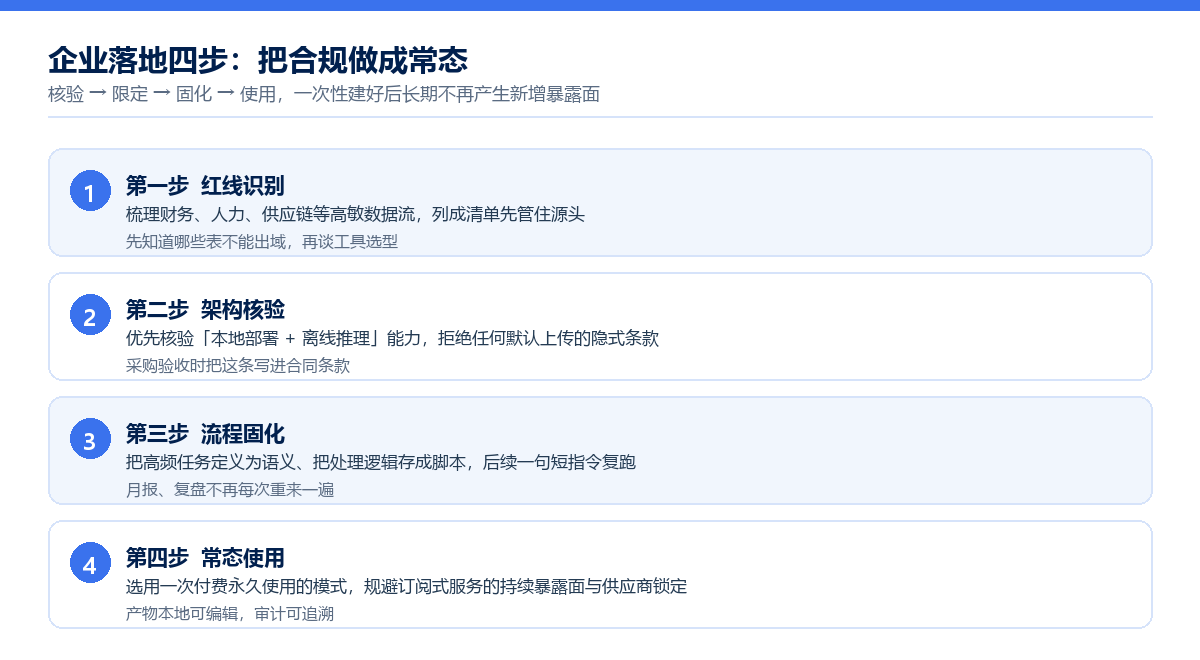
第一,引入智能工具时,优先核验"本地部署 + 离线推理"能力,拒绝任何默认上传的隐式条款。别只看宣传页的形容词,要看清它的默认行为。
第二,梳理财务、人力等高敏数据流,把它限定在本地智能体处理。先列清单,再谈工具——知道哪些表不能出域,比买哪个工具更前置。
第三,通过一次付费永久使用的模式,规避订阅式云服务带来的持续暴露面与供应商锁定风险。持续付费不只是成本问题,也是"这个工具下个版本还在不在"的问题。
落地验收清单
| 环节 | 核验动作 | 通过标准 |
|---|---|---|
| 红线识别 | 列出财务、人力、供应链高敏数据表清单 | 清单内表格明确标注"本地处理" |
| 架构核验 | 要求供应商说明默认上传行为并写入合同 | 默认不回传,且提供本地安装版本 |
| 流程固化 | 把高频任务定义为语义、处理逻辑存为脚本 | 同类任务可一句话复跑,不再重复对话 |
| 产物合规 | 确认报告在导出环节不依赖公网排版 | HTML / Word / PPT 本地出稿、可二次编辑 |
合规这件事,说到底不是买一个"更安全的工具",而是把数据面重新收回到自己手里。工具选型只是其中一步,真正决定上限的,是那条从导入到落盘都不出内网的路径搭得稳不稳。