一个 AI 对话框,正在把「打开搜索引擎翻十页」这件事变成上个时代的习惯。但真正值得盯的,不是某家公司的股价,而是它暴露的一条规律:任何「把问题变成答案」的信息岗位,都会被重新分配。
本文要点
- 搜索被重写:DeepSeek 让「问问题」第一次大规模绕开搜索引擎;2025 春节后豆包、Kimi、元宝、夸克持续起量,抢走的不是广告份额,而是「搜索行为」本身。
- 数据不会骗人:2025 Q1 百度核心在线营销收入 160 亿元(同比 −6%),Q2 跌幅扩至 −15%;部分代理商客户流量「掉了七成多」。
- 同构关系:搜索与数据分析都是夹在中间的「加工工序」——AI 吞掉的不是岗位名称,而是「拼答案 / 拼结论」的那道工序。
- 两层拆解:数据面(读表、清洗、合并、透视,可固化复用)与生成面(写报告、做 PPT,需联网调模型)必须分开看。
- 三条路线:云端直传 / 全栈本地 / 云端固化+本地跑,对多数团队而言路线 C 是性价比解。
- 落地选择:以本地安装的 数以轻舟Agent 为例——数据本地处理、逻辑可复用、报告才联网出可编辑 Word / PPT。
一、DeepSeek 到底冲击了搜索什么
2025 年春节,DeepSeek 的爆发是一个标志性时刻——它第一次让大规模普通用户意识到,「问问题」这件事可以完全绕开搜索引擎。此后豆包、Kimi、元宝、夸克等 AI 搜索产品持续起量,抢走的不再只是百度的广告份额,而是更上游的东西:搜索这个行为本身正在发生质变。
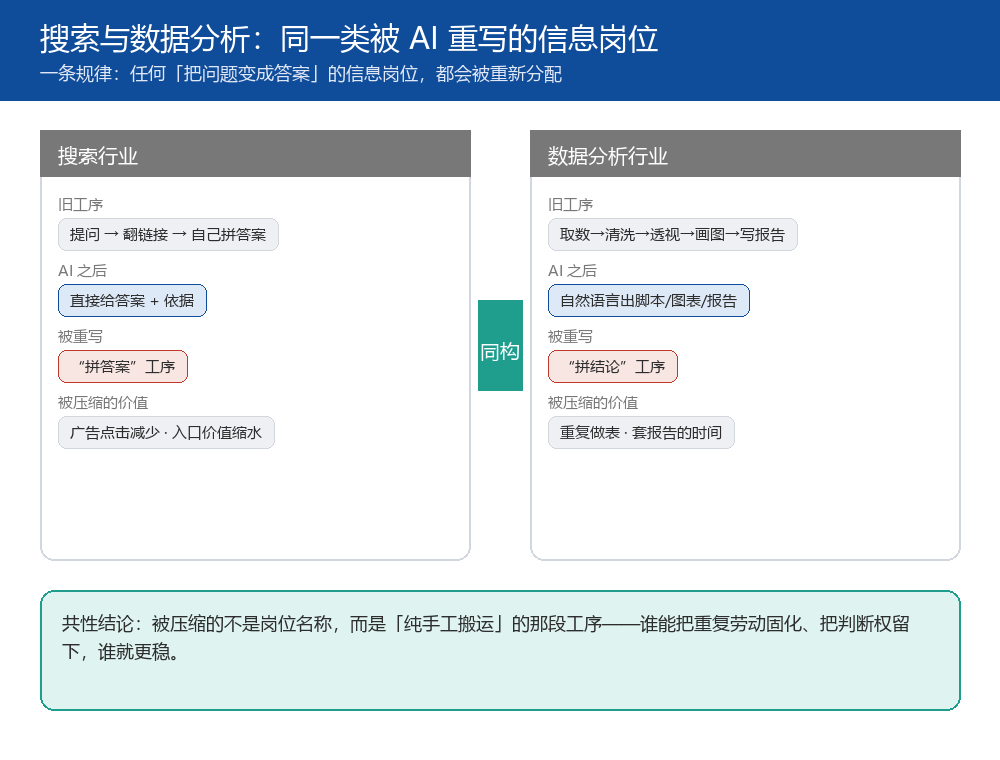
- 搜索的本质:人提问题,机器从海量网页里挑出「可能相关」的链接。它只给入口,不给答案。
- AI 搜索的本质:直接给答案,顺便给依据。它把「入口」这件事整个吞掉了。
- 数据不会骗人:2025 年 Q1 百度核心在线营销收入 160 亿元,同比下降 6%,Q2 跌幅进一步扩大至 15%;有媒体报道,部分代理商的百度广告客户流量「掉了七成多」。
- 真正的质变:用户过去搜索,是为了「找到一个链接、跳转到另一个页面」;现在越来越希望「直接得到答案」。答案一旦直接给,点击就减少,广告库存随之压缩,竞价空间随之收窄。
所以冲击的从来不是「搜索」这个动作,而是「人被迫自己拼答案」的那道工序。
二、搜索行业的事,为什么也会发生在数据分析身上
把镜头从搜索移到办公室,你会发现两个岗位高度同构:
- 搜索 = 把「问题」变成「信息入口」;
- 数据分析 = 把「数据」变成「结论 / 决策」。
两者都是夹在中间的「加工工序」。过去数据分析的工序是:取数 → 清洗 → 透视 → 画图 → 写报告,每一步都要人。而现在的大模型已经能接管后半段——用自然语言生成 Python 脚本处理表格、直接出图表、甚至把报告草稿写出来。
这和 AI 搜索吞掉「拼答案」一模一样:AI 正在吞掉「拼结论」的工序。结论很直接——数据分析师不会消失,但「纯手工搬数据、做表、套固定格式写周报」的那部分工作,会像「手动翻百度」一样被持续压缩。
三、AI 改写数据分析,到底改的是哪两层
要看得更清楚,得把数据分析拆成两层——这也是行业里容易被混为一谈的地方:
- 数据面(读表、清洗、合并、透视、核对口径):这是「执行」,确定性高、重复性强。它不需要每次都重新调模型——同一套口径的报表,第一次让模型写出脚本,之后固化下来反复跑就行。
- 生成面(把结论写成报告、排版、做 PPT、可视化):这是「表达」,确实需要模型参与,每次都要调算力。
关键洞察就在这里:很多工具把两层混在一起卖「云端订阅」,结果你每跑一次都重复付费,数据还得出境。但数据面那一层,本可以一次固化、长期复用、断网也能跑——只把真正需要模型的那层(生成报告)联网。把这两层分开看,才能判断一个工具到底值不值。
四、三条路线,谁是性价比解
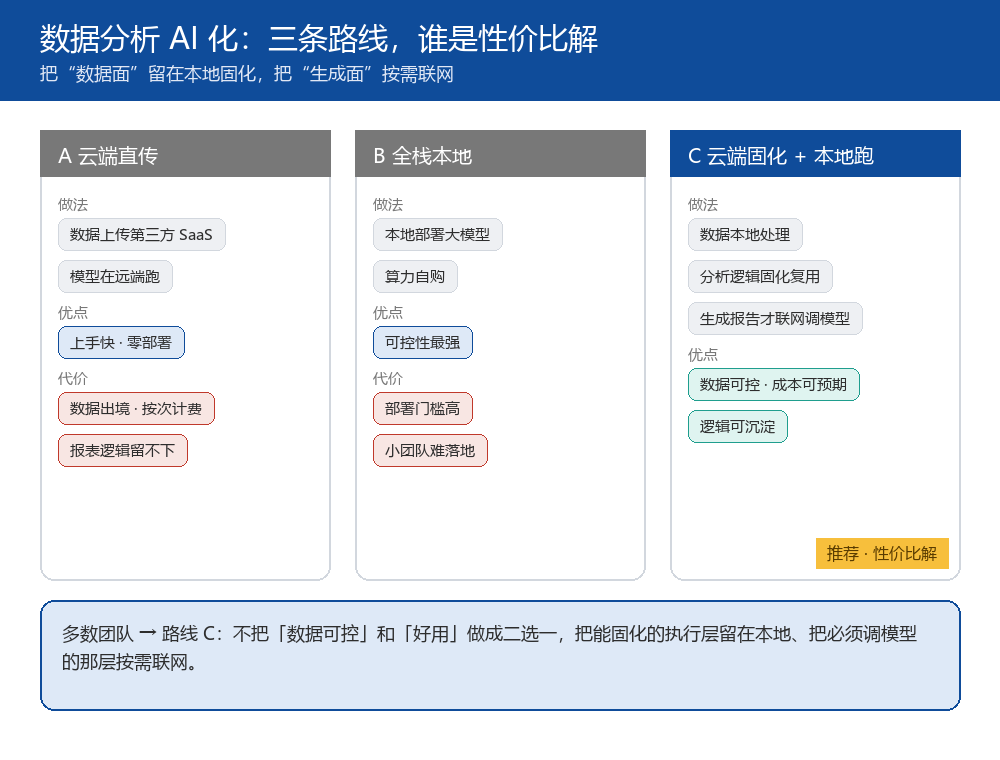
面对 AI 化,团队其实有三条路线可选:
| 路线 | 做法 | 优点 | 代价 |
|---|---|---|---|
| 路线 A 云端直传 | 数据上传第三方 SaaS,模型在远端跑 | 上手快、零部署 | 数据出境、按次 / 订阅计费、报表逻辑留不下 |
| 路线 B 全栈本地 | 本地部署大模型,算力自购 | 可控性最强 | 部署门槛高、对小团队不现实 |
| 路线 C 云端固化 + 本地跑 | 数据本地处理,分析逻辑固化复用,生成报告才联网调模型 | 数据可控、成本可预期、逻辑可沉淀 | 需自行接入算力 |
对大多数团队而言,路线 C 是性价比解:它不把「数据可控」和「好用」做成二选一,而是把能固化的执行层留在本地、把必须调模型的那层按需联网。
五、落到工具上:一个轻量的现实选择
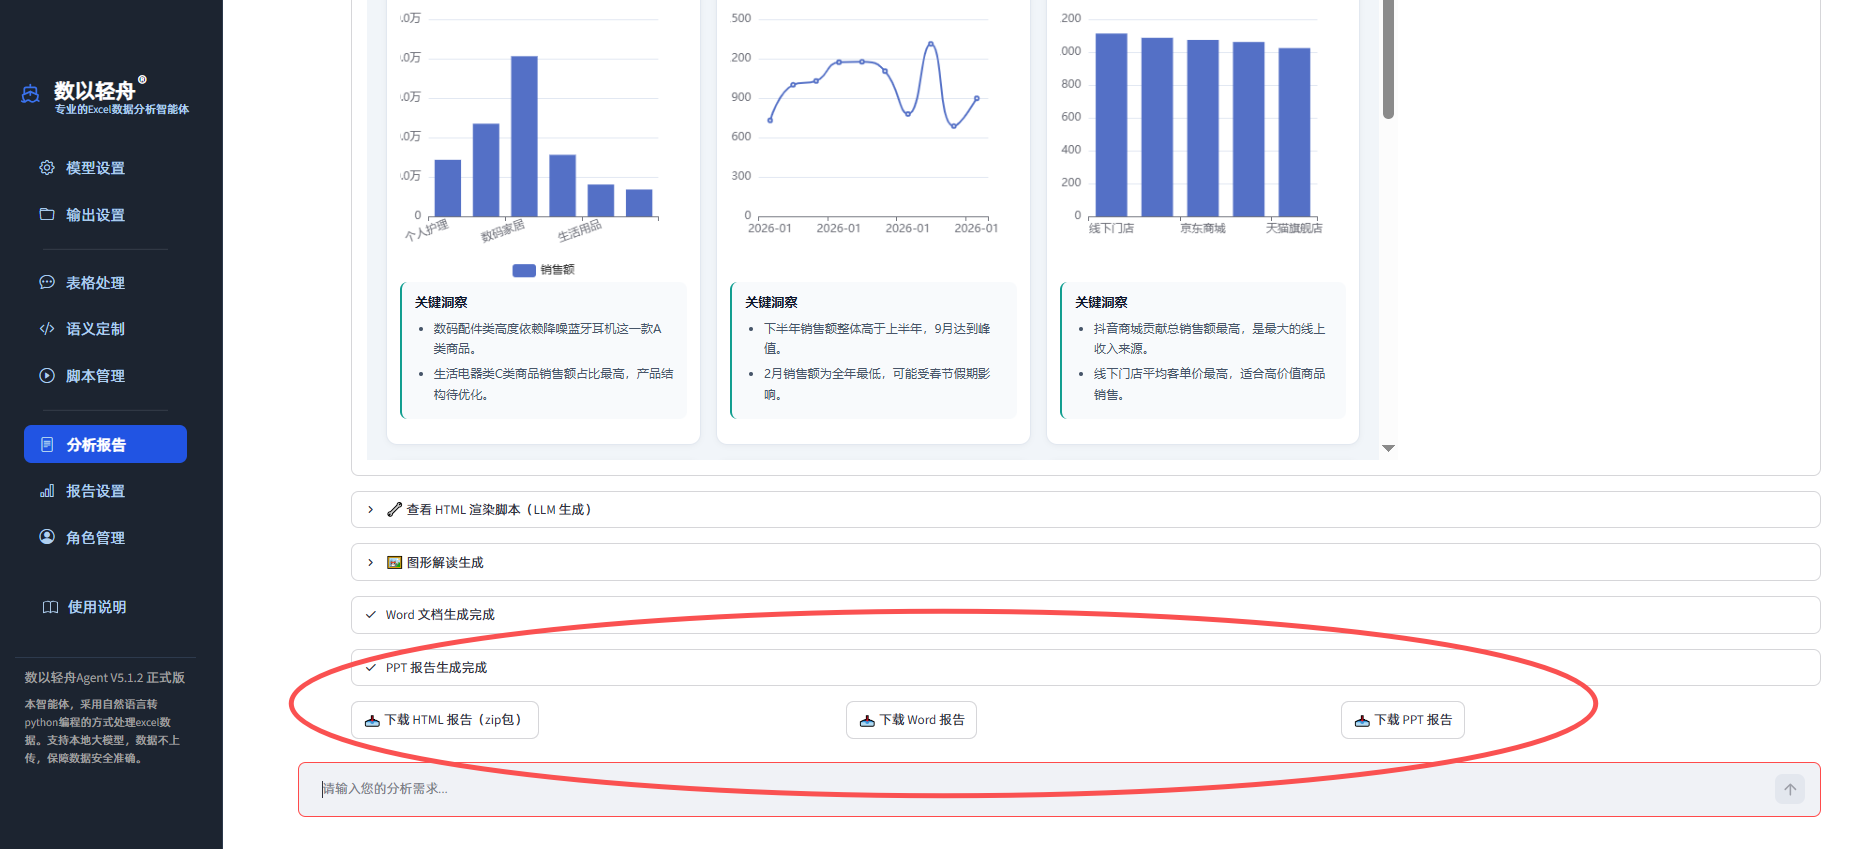
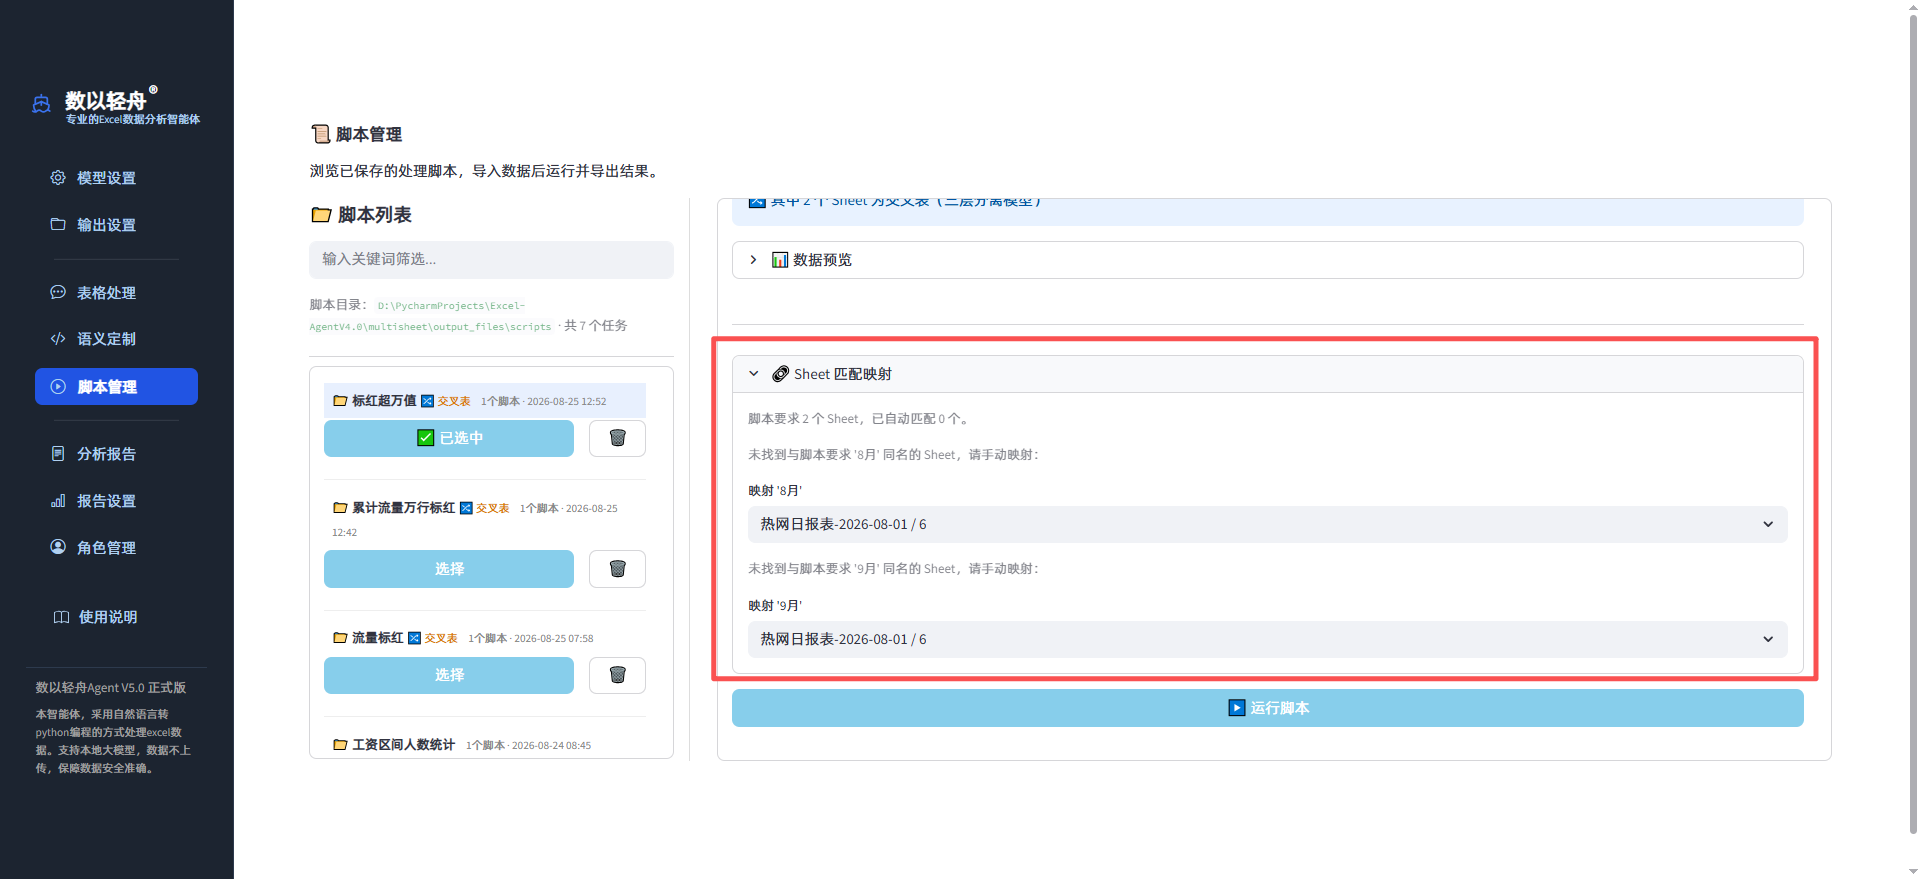
把路线 C 落到具体工具上,举一个轻量的例子。像 数以轻舟Agent 这类本地安装的 AI 数据分析工具,做的就是这件事——数据文件本地处理(不进聊天框、不传第三方 SaaS),把分析逻辑固化复用、沉淀为可复用的数据分析资产;而报告生成(可编辑 Word / PPT)才需要联网调用模型。
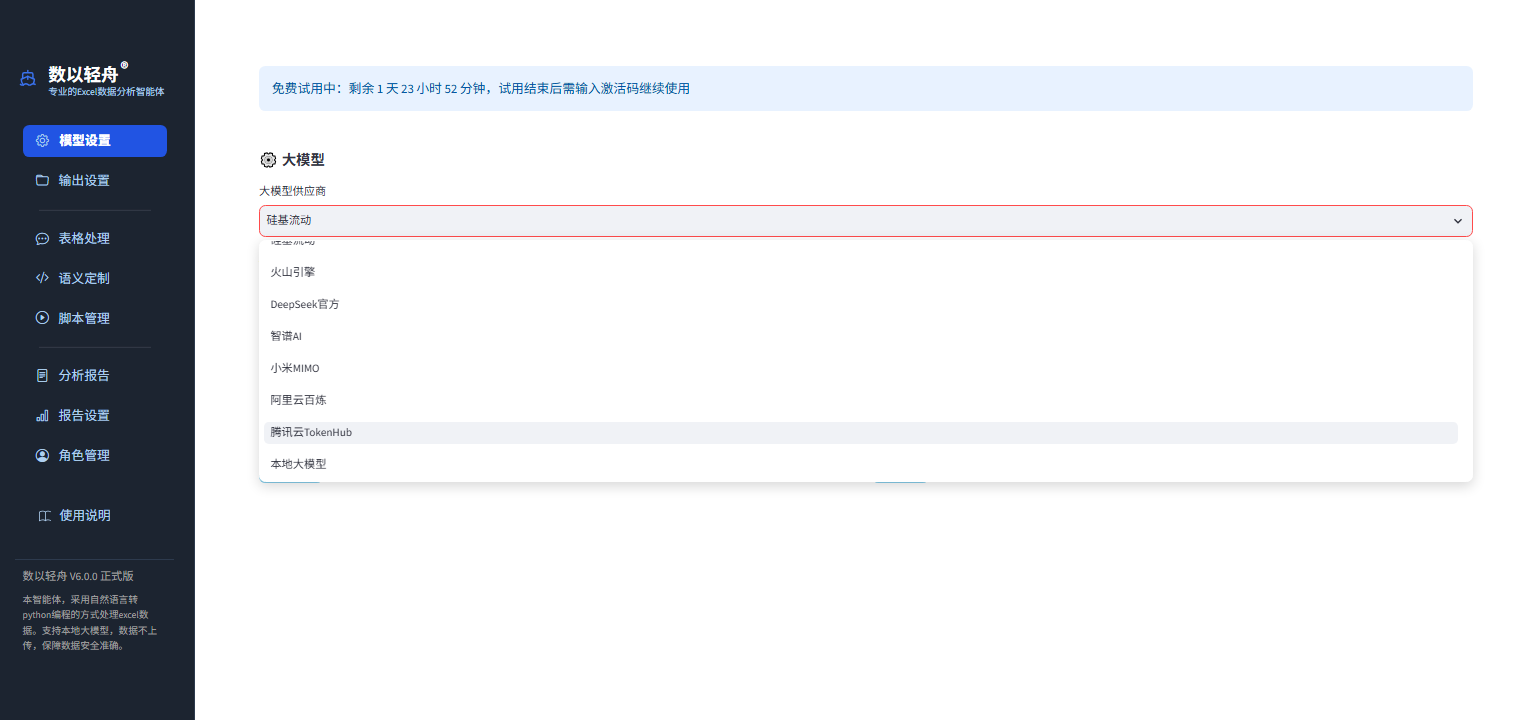
它支持接入多种大模型接口(智谱 AI、DeepSeek 最新模型等),不绑定单一默认模型,有新模型出来可以直接换上。更进一步,数以轻舟Agent 的做表功能让不懂代码的人也能让大模型写 Python 脚本,把分析逻辑固化下来;下次同口径报表一键复用,不再消耗 token。
能力边界也要说清楚:它输入仅支持 xlsx / csv,输出支持可编辑 Word / PPT 与 HTML 看板;本地安装、软件一次性付费(算力需自购接入)。它不是「什么都不用学」的黑盒,而是把重复劳动固化、把判断权留给你。
六、给数据分析人的三条建议
- 别恐慌「被取代」,该警惕的是「只会手工搬数据」。岗位不会消失,消失的是低价值的搬运工序。
- 把重复性的取数、做表固化下来。让自己腾出手去做「提问题、定口径、做判断」的高价值部分。
- 选工具看三点:数据是否本地处理、逻辑能否复用沉淀、报告能否直接交付(可编辑,而非一张截图)。
软收尾
当搜索被 AI 重写,数据分析也不会例外。真正稳的,不是某个岗位名称,而是你手里那套能沉淀、能复用、数据可控的分析能力。
参考资料:
· 百度投资者关系:百度核心在线营销收入等季度财务数据,见各季度业绩公告。
· 中国信息通信研究院:企业私有化 / 本地化部署大模型的相关行业研究与测算口径。
· 公开媒体报道:2025 年以来 AI 搜索产品(豆包、Kimi、元宝、夸克等)用户起量、对搜索广告库存的影响。
本文由 AI 辅助生成,经人工审核。
更多数据实战与行业观察
数据本地处理、口径可固化、逻辑可复用。前往文章中心,查看完整的销售、库存、财务、HR 实战案例与行业分析合集。