做过 HR 的人都有同感:数据清洗根本不是技术活,是个体力活,而且还不能出错。月底那几天,考勤记录、请假审批、加班明细、工资表、社保基数,全堆在一起。考勤机导出的流水可能上万行,同一个员工一天打好几次卡,要合并、要去重、要对请假;工资表要跟考勤对上,跟社保公积金挂钩,一行都不能差。我做 HR 系统对接这些年,见过太多人在这一步熬夜:用 VLOOKUP 一个个拉、手工删重复行、复制粘贴补空值,一套流程走完,天都亮了。今天这篇,就围绕"HR数据清洗"到底该怎么做,讲清楚一条能真正省心的思路。
一、为什么 HR 数据清洗这么累、还总出错?
先把这个问题的根源拆开。HR 的数据有一个共同特点:来源杂、字段多、量也不小。考勤是打卡机导出的,工资是财务那边给的,请假加班来自审批系统,社保基数又有一套自己的口径。几套数据要合并到一张表里,第一步就是对不上:员工号在考勤表里是"工号+部门",在工资表里只剩工号;同一个姓名,考勤表写成"张三",工资表写成"张 三"或"张三(市场部)"。
其次是脏,重复打卡、空值、格式不统一到处都是;最后是怕错,工资、个税、社保这类数据,错一行都是客诉和麻烦。所以"HR数据清洗"真正的难点,不在数据本身,而在于它反复出现、每次都要重来,一旦用错了方法就特别费人。
二、核心特点:一条省心的清洗思路长什么样?
我的建议是,别把"清洗"当成一次性的苦力,而要当成一套"能复用的流程"。具体看三点。
- 规则能不能沉淀:这次定好的去重规则、口径对应规则,下个月能不能直接套用,而不是每次从头写。
- 过程能不能回看:改了什么、为什么这么改,要能查得回来,尤其工资表这种容不得差错的,出了数能回去对账。
- 数据文件在哪儿处理:考勤、工资、社保都算敏感信息,能不能留在本机、不进聊天框、不传第三方平台。
按这三条去选,本地安装、数据文件本地处理、处理脚本本地保存的"数以轻舟",正好把三条都占住——它不是云端那种"表传上去、结果拿下来"的黑盒,而是把处理逻辑留在你电脑上跑完。
三、对比:本地处理与云端工具,谁更适合 HR 场景?
把两类放一起看,差别很具体。
| 对比维度 | 云端工具 | 本地处理(数以轻舟) |
|---|---|---|
| 数据出域 | 基本都要先把文件上传,工资表、身份证号、社保信息走这个链路,很多公司内部有合规要求,不一定允许 | 文件不出本机,只有生成脚本那一步联网调算力,而且用的是脱敏样本 |
| 计费 | 常见按积分、按订阅,用量一大月底账单跟着涨 | 软件一次买断,模型算力自己接入、按量购买,内置 token 优化压低消耗 |
| 可复查性 | 给结果、过程通常是黑箱 | 每一步跑过什么、规则怎么写的都在本机记录里,出了数能回去对 |
| 格式边界 | 只支持 xlsx / csv | 只支持 xlsx / csv;旧版 .xls 要先另存为 .xlsx,PDF、图片、Word 暂不支持 |
四、核心功能:拿一张月度考勤工资表实测
具体到功能,我用一张包含考勤和工资两个 sheet 的月度表做了实测,覆盖 HR 最常碰的几类活。
- 常见脏数据清洗:同一个员工多次打卡只保留最早一次或最晚一次、空白单元格补值、日期(几月几日)和金额列格式统一,我用一句自然语言下指令,脚本就在本地生成并运行,几秒出结果,不用手动一条条改。
- 跨表核对:考勤表的出勤天数要跟工资表的应发工资对上,两表按员工号匹配,缺勤、多记、金额不一致直接标出来,比 VLOOKUP 一个个拉省心太多。
- 口径统一与规则复用:这次定好的"请假怎么扣、加班怎么算"规则会作为脚本保存在本地,下个月再对同一批表,直接捡起来跑,断网也能运行,不用每次重写。
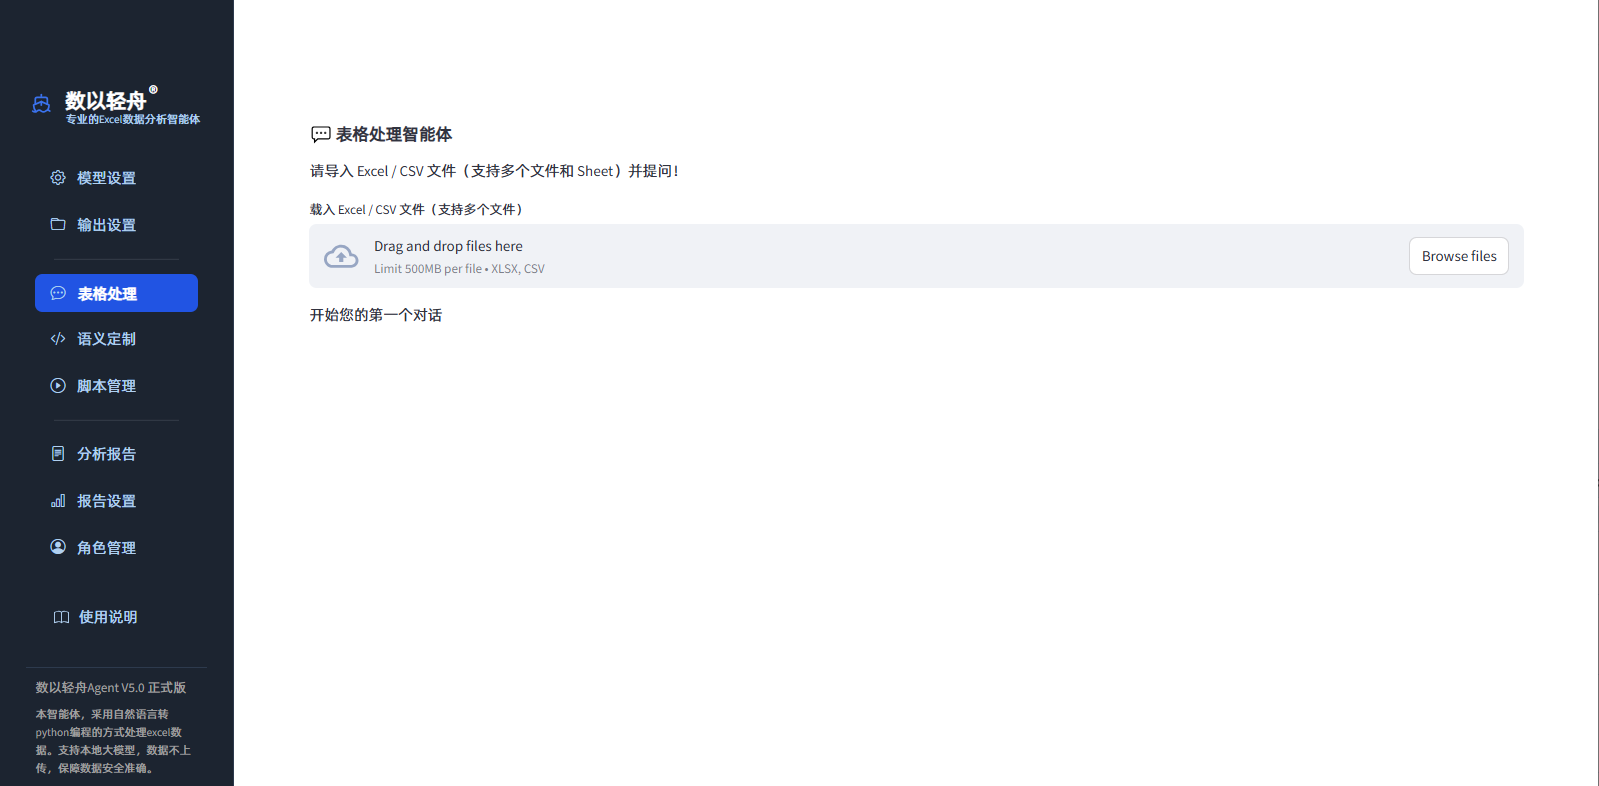
整个流程我没有写任何代码——指令用自然语言,脚本由工具自动生成并运行,跑完还能回看每一步。边界也如实讲:它处理的是表格类数据,别拿 PDF 扫描的考勤表、图片工资条来试,那样暂不支持;首次生成脚本仍需联网调用算力,这个环节跳不过去。
五、适合谁,什么人不建议
这套思路适合的人群很明确:HR、人事、薪酬、行政岗,每个月要处理考勤、工资、社保相关表格,但不想为这件事自己写代码的人;还有对员工隐私敏感、需要把数据文件留在本机处理的部门。
反过来,两类人不建议用:一是期望开箱即用、什么都不用配置的,因为模型算力需要自己接入 API 并按量购买,这个门槛要提前认;二是手头要处理的是 PDF 扫描件、图片这类非表格文件的,那它帮不上忙,先把文件另存为表格格式再说。会不会写代码不是门槛——脚本由数以轻舟 在本地自动生成并运行,用户不碰代码。
六、FAQ:三个 HR 最常问的问题
问:买断是不是就等于从此不再为软件花钱?答:不是。买断的是软件本体授权,模型算力要自己接入、自己向模型厂商购买,产品不代充、不抽成,内置 token 优化会帮你把消耗压低。
问:工资表这种容不得差错的,处理过程能复核吗?答:能,脚本和运行记录都留在本机,每一步做了什么都能回看,不像云端工具交回一个结果就完了。
问:支持多少数据量?答:支持 250 万行以上、文件无大小限制,几万行的考勤工资表没压力,前提是格式为 xlsx 或 csv。
说到底,数据留在自己电脑上、脚本还能留着下次复用,比反复手工对表省心得多。HR数据清洗这件事,关键不是每次多卖力,而是把规则沉淀下来、下次直接复用——这三点想清楚了,月底就不再那么难熬。