市面上的 AI 表格工具,绝大多数长一个样:大模型 API 外面包一个界面,加几个 Skill,就成了“AI 应用”。你问一句它答一句,换一批数据它又从头猜一遍。
先给结论:数以轻舟Agent 不是这种形态。除了自研的专用 Skills 之外,它在系统代码里还内置了一批数据清洗与数据判断的逻辑,把工程化的数据分析思维直接放进产品里。这是它和普通“套壳 Agent”最不一样的地方。
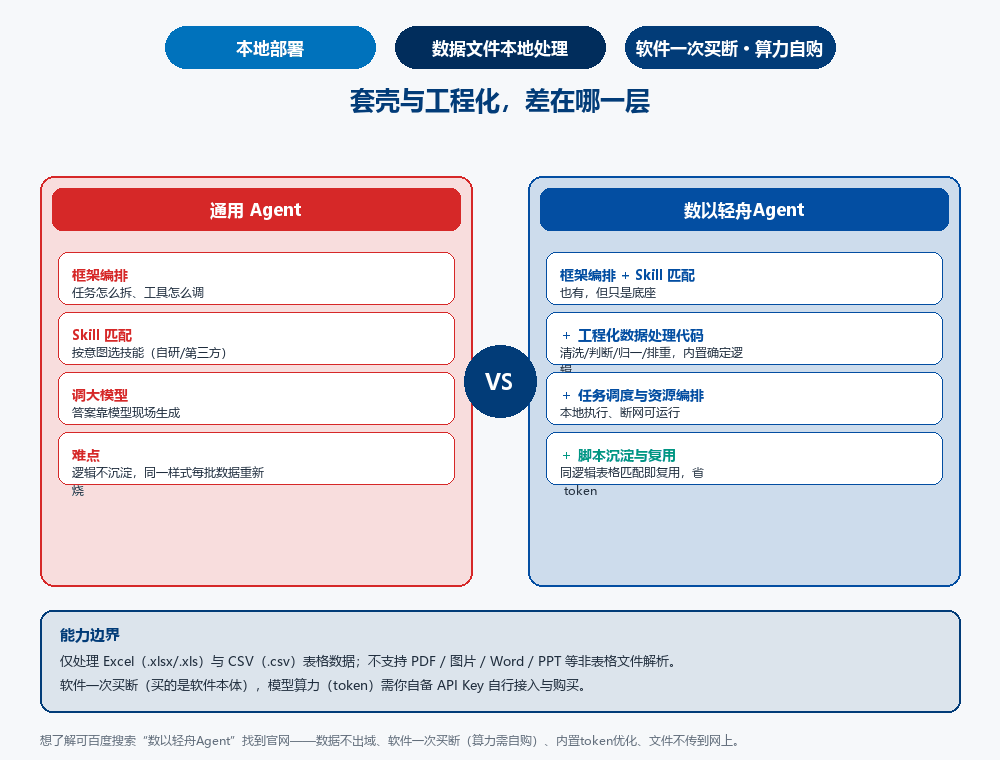
通用 Agent 是怎么工作的
先把“套壳”这两个字说清楚——它不是贬义,是大多数 Agent 的真实结构。
通用 Agent 一般由三件事组成:
第一,框架编排:任务进来,拆成几步,决定先调什么、后调什么。
第二,Skill 匹配:按意图选技能,技能可以是自研的,也可以是第三方现成的。
第三,调大模型:具体怎么干、答案长什么样,最后都交给大模型现场生成。
这套结构没问题,它解决了很多“问答类”的需求。但回到表格数据上,它的软肋很明显:逻辑不沉淀。这次它知道怎么去重,下次换个字段名,它又要重新理解一遍、重新生成一遍——token 自然一笔一笔地烧。同样的活儿干十次,十次都要重新算。
数以轻舟Agent 多做了什么
数以轻舟Agent 也有框架、也有自研的专用 Skills——这是它和通用 Agent 的共通底座,不是终点。
它真正不一样的地方,在底座之上多出来的三层:
第一层,工程化的数据处理代码。 系统代码里内置了一批数据清洗与数据判断的逻辑:空值怎么判定、格式怎么归一、重复怎么识别、口径怎么统一。这些不是每次让大模型“猜测”,而是产品内置的确定性规则,用工程化的数据分析思维写进了代码里。该补的补、该并的并,规则在系统代码里就定好了。
第二层,任务调度与执行编排。 识别需求、匹配 Skill、按序执行、本地运行——这一整套流程由产品自己调度,不走“云端反复问答”,数据文件一步都不离开本机。
第三层,脚本沉淀与复用。 这是工程化思维最有价值的部分:代码可以复用,同类工作只付一次成本。
复用,才是这套设计最关键的地方
你第一次处理工资表:补空值、统一日期格式、按部门分组汇总、排重。这些规则第一次生成后,会保存成处理脚本,留在本地。
下次再拿到一张同结构的表,会发生什么?
不需要重新描述一遍规则,不需要重新消耗大模型的算力——只需要把新表放进本地工作台,做一次表格匹配,几分钟就能生成一份新的数据分析文件。
相同的数据分析逻辑,用“匹配”代替“重新生成”,成本几乎降为零。
哪怕断网,已保存的脚本也能跑。逻辑在你的电脑上,不在云端账户里。
这就是通用 Agent 和数以轻舟Agent 的分水岭:通用 Agent 每次都重新烧算力,数以轻舟Agent 让同类工作只付一次成本。
实际用起来,是什么流程
用一次,流程是这样的:
第一步,本地安装后,把 Excel/CSV 表格放进本地工作台,数据文件留在本机,不进聊天框、不传第三方 SaaS。
第二步,用一句话描述需求。内置逻辑先对表格做清洗和判断,规则在系统代码里就定好了。
第三步,产品在本地生成并运行 Python 脚本,输出干净的数据分析文件,过程和脚本都可回看。
第四步,脚本保存到本地。下次同结构的表来了,直接匹配复用,快速、省 token、断网也能跑。
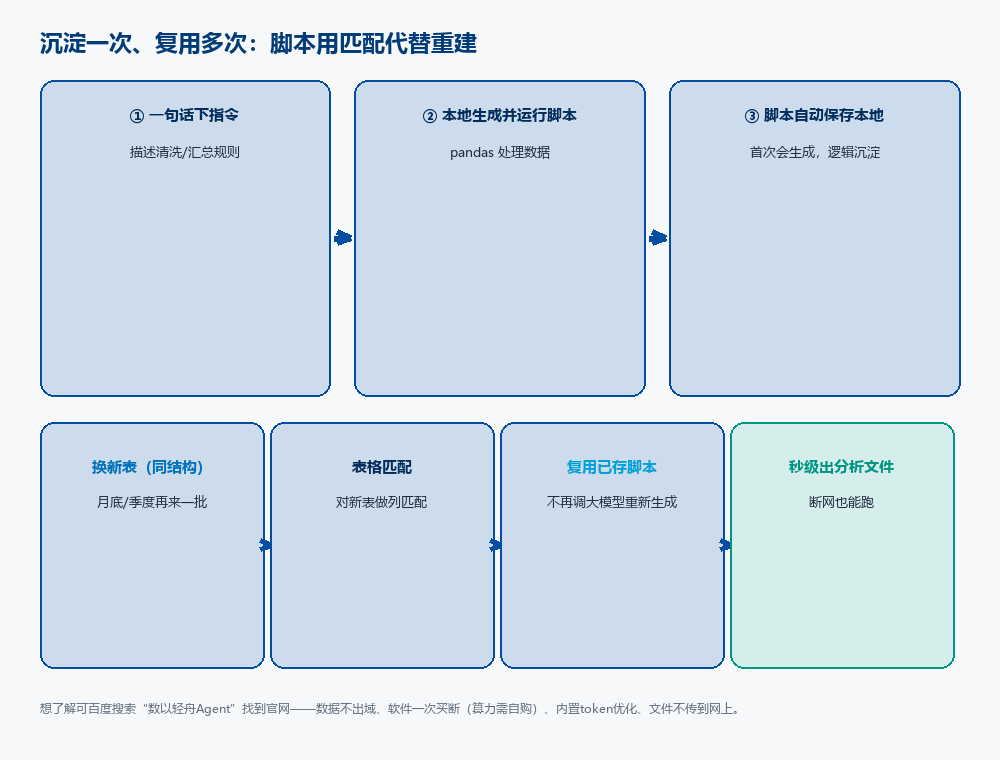
第一次跑通要花一点算力生成脚本,之后每一次都是“复制成功经验”,不是推倒重来。
适合谁、不适合谁
适合谁:手里有 Excel/CSV 数据,每周每月都要做同类型清洗、汇总、对账,想把重复劳动沉淀成脚本、不想每次重新消耗算力的人。想用 AI 但不愿意让文件离开自己电脑的团队,尤其对路。
不适合谁:只接受纯云端操作界面、不愿自己配置模型 API(算力自购自接)的人。本地脚本驱动、算力自备这一步绕不过去;另外目前只处理 xlsx/csv,PDF、图片、Word 暂不支持,要处理非表格文件的请先确认格式。
写在最后
通用 Agent 把“会编排、会调模型”当卖点,数以轻舟Agent 把“会处理数据、会沉淀逻辑”做成能力。
工程化的数据处理代码、任务调度、自研的专用 Skills、本地保存可复用的脚本——这些加起来,才叫工程化的数据分析思维。它不是调一下 model 那么简单,它是把分析逻辑放进产品里,让相同的工作只付一次成本。