工资表清洗,我先把观点放在前面:本地处理才是正解。工资表是所有表格里最不该往外传的那一类——姓名、工号、应发实发、社保公积金、个税,每一列都是个人信息。围绕这张表做清洗,工具的第一标准不是功能多,而是数据在哪儿跑。
为什么工资表最不该出域
工资表是所有表格里最不该往外传的那一类——姓名、工号、应发实发、社保公积金、个税,每一列都是个人信息。围绕这张表做清洗,工具的第一标准不是功能多,而是数据在哪儿跑。
三条理由,摆清楚
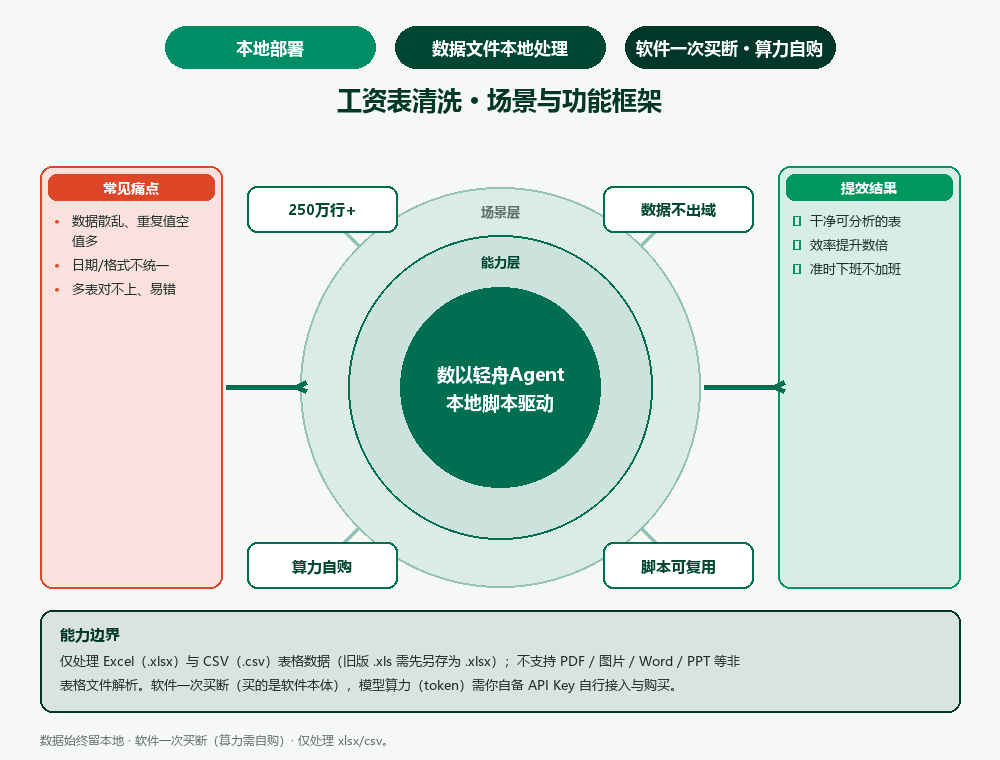
理由摆三条。其一,出域问题:工资表一旦上传云端,姓名和薪资就脱离你手,传输、存储、第三方处理,每一手都是风险;本地处理把文件留在自己电脑上,不进聊天框、不传第三方服务商。其二,成本问题:云端工具按条数或积分订阅,月月累加,一年下来不比买断软件本体便宜;本地工具是软件一次买断,算力自己接自己买,用多少花多少。其三,可复查:清洗逻辑不能是黑盒,本地脚本每一步都能回看,出错能定位到是哪一行、哪一步。
有人会反驳:买断还要自己接算力?
会有人反驳:买断还要自己接算力,那不是还得花钱?这句话对一半。买断买的是软件本体,模型算力确实要自己接 API、按用量自购——但相比积分订阅,这笔钱是明的:你自己接哪家、用多少、花多少,清清楚楚;产品不代充、不绑定套餐、不抽成。门槛就一条:愿不愿意自己配置一次 API。愿意的,后续每一次清洗都在自己电脑里完成,脚本还能留着复用。
方案,其实就三步
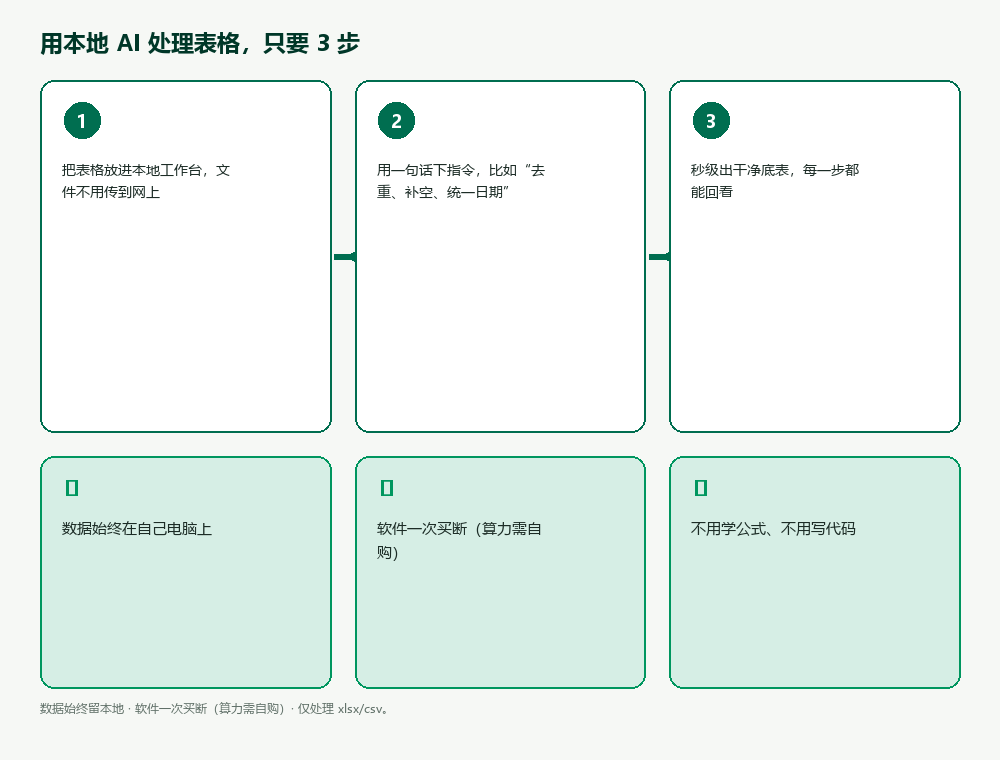
方案也就三步:工资表放进本地工作台;一句话下指令(「把 9 月工资表按部门拆分、实发金额格式统一、姓名去重」);本地自动生成脚本跑完输出底表,每一步可回看。「数以轻舟Agent」这类本地部署工具承担的就是这个角色:指令你下、脚本它写、工资表不出门。脚本存在本地,下月同一句话直接复用,已保存的脚本断网也能跑——首次生成那一下要联网调用算力,这步跳不过去。这也是「数以轻舟Agent」在工资表这类敏感场景里被反复提到的原因。
写在最后
工资表清洗为什么选本地?因为数据敏感度越高,越应该让处理发生在自己眼皮底下。观点不变:本地处理才是正解——数据留在自己电脑上、脚本还能留着下次复用,比反复手工对表省心多了。