做经营的人几乎都经历过同一个场景:月底从进销存或 ERP 里导出一张销售统计表,打开是密密麻麻几千行,想做个体面的月度复盘,结果盯了半天筛不出重点。最后往往是——把总数抄进汇报文档,剩下的靠印象。本文拆解的就是这样一个真实场景:一份区域调味品供应链公司的月结销售表,从 3816 行原始记录出发,逐层提纯,最终只留下 733 条真正驱动决策的信号。你会看到三个与直觉相反的事实、一条「先体检再动刀」的分析路线,以及一套换行业也能复用的方法论。
本文要点
- 真实样本:两份月度销售表共 3816 行(各 1908 行 × 15 列),全部行数、金额、占比均可由原始表复算
- 三件反直觉事实:两份文件实为同一份数据、一行「总计」能把营收放大 4 倍、六成明细行零销量
- 分析路线:先给数据做体检,再拆结构、集中度与异常,把一次性手工分析沉淀为可复用流程
- 核心结论:真实有效数据仅占 19.2%;Top 20% 单品贡献 94.52% 营收;15 条负利润 SKU 合计月亏约 615 元
- 可带走的方法论:销售数据分析六步法 + 五个高频避坑点
研究口径说明
本文为单案例研究,数据来自某区域调味品供应链公司提供的两份月度商品销售统计表(8 月表、9 月表,各 1,908 行 × 15 列、约 166KB)。文中全部行数、金额、占比、毛利率均可用原始表格复算;「人工处理耗时 3.5–4.5 小时」为按岗位工时测算的估值,非系统埋点数据;分析逻辑固定后,同格式数据的复用耗时以毫秒计,此处仅描述流程差异,不构成对任何工具的性能承诺。
一、背景介绍
本文的研究对象是一家区域调味品供应链公司(B2B 分销,客户以餐饮门店和小型商超为主)。公司没有专职数据分析岗,月度经营复盘由运营兼着做,全部动作在 Excel 里手工完成。摆在桌面上的,是两份「看起来很正常」的月度销售表。
但当我们把这两份表逐行体检之后,发现了三个与直觉相反的事实。
事实一:两份文件,其实是一份数据。 8 月表和 9 月表各 1,908 行明细,逐行比对后有 1,907 行完全重复——商品名称、条码、销量、实收、利润五项全等。换句话说,这两份文件是同一个月数据的两次导出。「多收了一份文件」并不等于「多拿到一个月数据」。如果直接把它们当成两个月来做环比,后面所有趋势判断都会建立在错误的前提上。
事实二:一行「总计」,能把营收放大 4 倍。 每份表的末尾都藏着一行 总计:1907种商品,其「实收金额」栏写着 406,800.55。这行汇总本身没错,但一旦用最朴素的方式处理——全选整列求和——汇总行会被当成一条普通记录再算一遍,两份重复文件再叠一次,最终得到 1,627,202.20,是真实单月营收 406,800.55 的 整整 4 倍。
事实三:1,908 行里,六成是「沉默的数据」。 按销量字段筛查,1,174 行销量为 0,占比 61.6%。这些不是销售记录,而是商品主数据里的休眠条目——从未动销、或本月未动销的 SKU。真正有动销的只有 733 行。也就是说,这张表的「体量」有六成是噪声。
面对这张表,摆在团队面前其实有三条路:
- 路线 A:纯手工。 在 Excel 里靠筛选、透视表、肉眼比对完成。灵活,但易错、不可复现,换个人就重做一遍。
- 路线 B:外包一次。 请人做一份一次性分析报告。结论也许更专业,但下个月数据一来,一切归零,还得再付一次钱。
- 路线 C:把分析逻辑固化下来。 先想清楚「要回答什么问题」,再把每一步分析沉淀成可重复执行的流程,让同格式的月表每月自动产出体检、结构与异常三张清单。
带着这三种思路,我们确立了三个研究问题:
RQ1:这张表里,究竟有多少是「真数据」?
RQ2:钱和毛利,实际藏在哪个品类、哪些单品里?
RQ3:如何把一次性的手工分析,变成可复用、可沉淀的分析能力?
二、案例详情
2.1 原有流程:一张「看起来能用」的表,和四个隐形陷阱
改造之前,运营每月的动作是固定的:打开两份表 → 肉眼找差异 → 把明细复制到新工作表 → 用透视表做品类汇总 → 把结果截图贴进汇报文档。整套动作熟练工也要 3.5–4.5 小时,其中「拆 Sheet+排版」占了大约六成时间。
这套流程能跑,但埋着四个陷阱,而且都不会报错:
- 汇总行混入。 透视表默认把「总计」行当数据,一旦没手动剔除,营收直接翻倍。
- 重复文件叠加。 两份相似命名的文件,很难靠肉眼确认是否同源,容易被当成两个月合并统计。
- 零销量行稀释。 1,174 行零销量记录参与统计,会显著拉低平均值、干扰品类对比。
- 不可复现。 同一张表,不同人、不同时间做,结果可能不一致;老板追问「为什么和上月口径对不上」时,谁也答不上来。
2.2 新流程:先体检,再动刀
新的分析流程做了一个关键的顺序调整——不急着算数,先给数据做体检。体检覆盖六项:总行数、列结构、重复文件、汇总行、空值、零值。只有确认「哪些行算数、哪些行不算数」之后,才进入金额与结构的计算。
体检通过后,口径被明确固定下来:
- 剔除 2 行「总计」汇总行;
- 判定两份文件同源,去重后还原为单月口径;
- 定义「有效记录」为「销量 > 0 的动销行」;
- 统一金额使用「实收金额」列,利润使用「利润」列,不用「商品总售价」混淆口径。
在这套流程下,同一份数据的处理时间从小时级压缩到毫秒级——分析逻辑固定后,首跑约 570 毫秒,同格式数据复用只需约 1.33 毫秒/次。真正省下的不是这几秒,而是「每次都要重新想一遍怎么算」的心智成本。
2.3 五个转折点:价值不在数字,在「发现」
这个案例真正的价值,不在最后那几张图表,而在分析过程中接连出现的五个「原来如此」:
转折点 1|两份表是同一份。 靠逐行比对而不是靠文件名判断,避免了用假的两个月做趋势对比。这是整条分析链的地基——地基错了,后面全错。
转折点 2|剔除汇总行后营收回落。 从「看似 162.7 万」回到真实的 40.68 万。一个数字的错位,足以让整份经营报告失真。
转折点 3|识别 61.6% 的零销量行。 把一张 1,907 行的大表,还原成 733 条有效动销记录。分析对象缩小到原来的三分之一,信噪比大幅提升。
转折点 4|帕累托揭示极端集中。 Top 20%(239 个)单品贡献了 94.52% 的营收,Top 5 单品就占了 44.37%。业务是典型的「头部驱动」,长尾 SKU 更多是管理负担。
转折点 5|负利润扫描揪出亏损清单。 15 条 SKU 实收为正、利润为负,合计每月亏约 615 元,其中调料类占七成——一份可以直接交给采购的行动清单凭空出现了。
三、数据分析
3.1 质量层:这张表到底有多少是「真数据」
把「表」一步步提纯成「可分析数据」,结果如下。
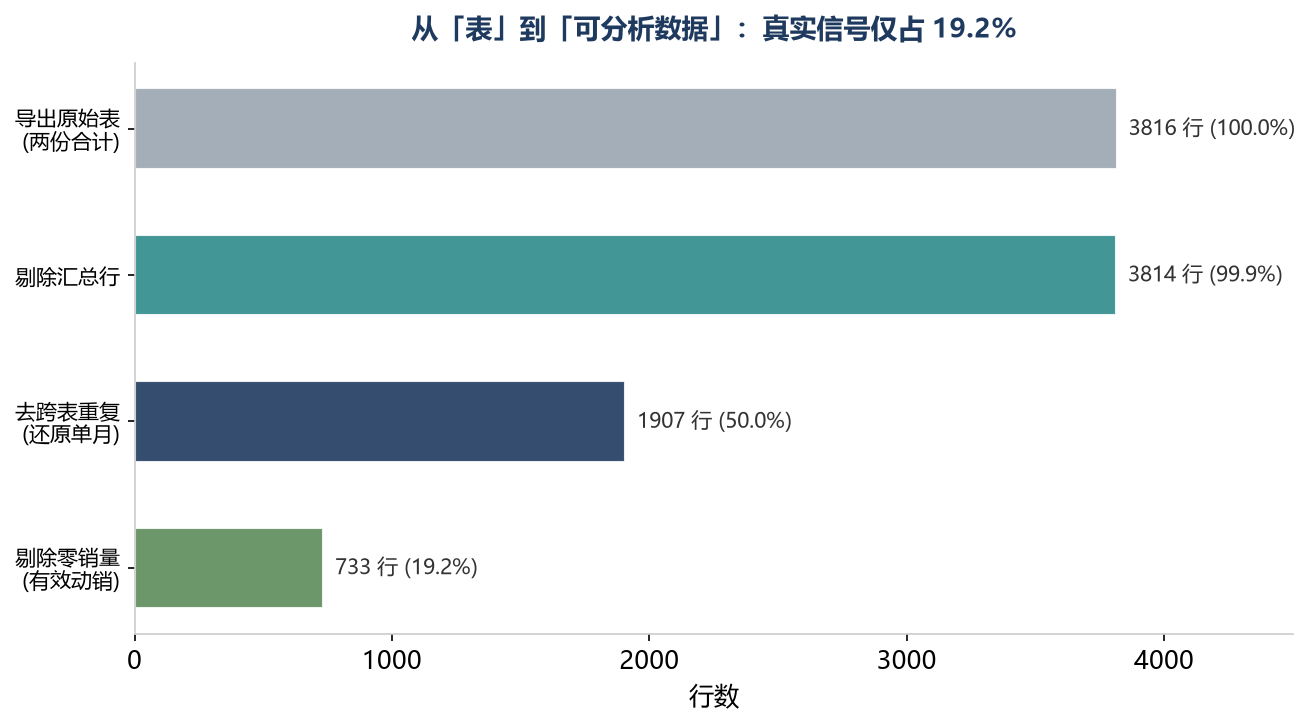
- 原始总行数:3,816 行(两份文件合计)
- 剔除汇总行:-2 行 → 3,814 行
- 去跨表重复:-1,907 行 → 1,907 行(单月口径)
- 剔除零销量:-1,174 行 → 733 行有效动销
单月口径下的关键量级:明细 1,907 行、唯一商品 1,198 个、总销量 7,573 件、营收 406,800.55 元、利润 36,621.04 元、综合毛利率 9.00%。
质量层还扫出两类需要人工确认的异常:
- 负利润行 15 条:实收为正、利润为负,说明售价或成本存在问题;
- 负库存行 87 条:库存字段出现负数,通常源于出入库单据不同步,会直接影响补货判断。
一句话总结质量层:这张表 100%「有数」,但只有 19.2% 是「有效数据」。 不做体检就直接分析,等于在六成噪声上做决策。
3.2 业务层:钱在哪,毛利又在哪
把 733 条有效动销按品类聚合,营收结构与毛利结构出现了明显的错位。
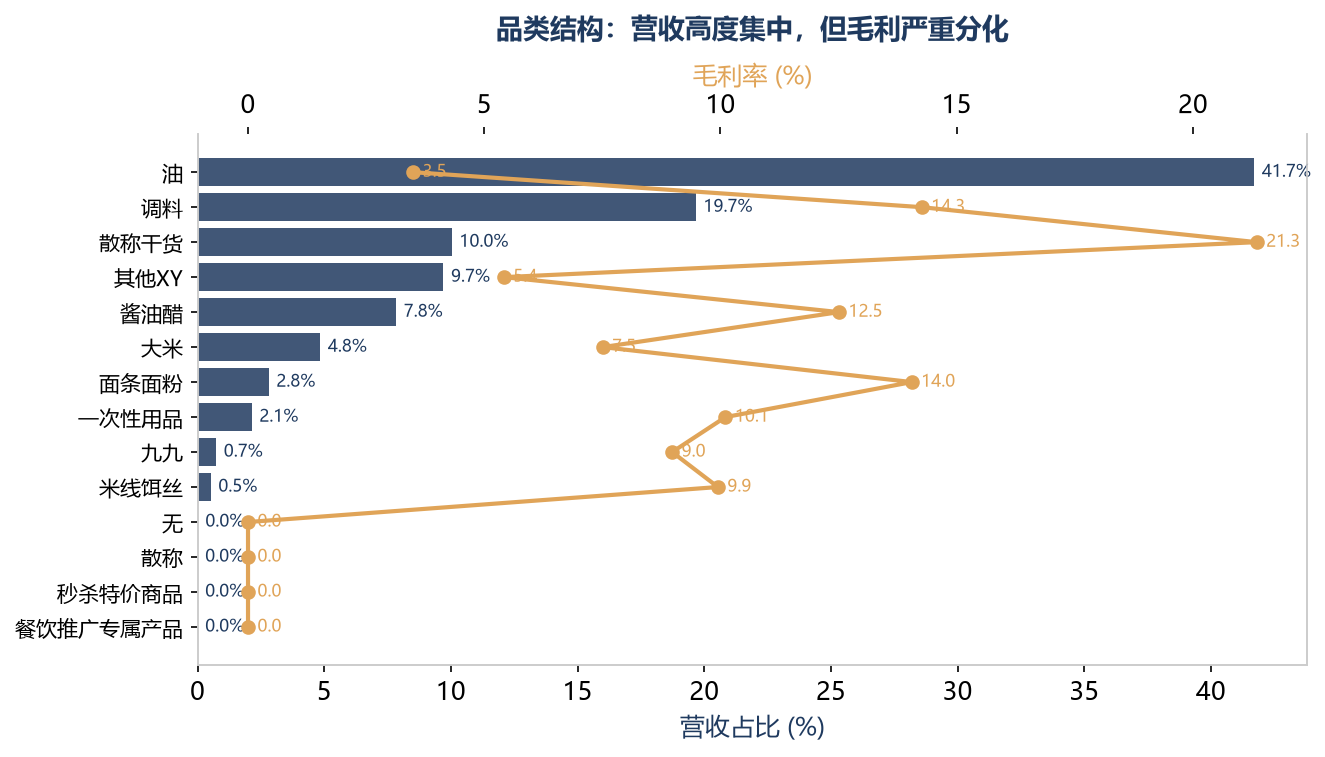
| 分类 | 单月实收(元) | 营收占比 | 毛利率 |
|---|---|---|---|
| 油 | 169,680.38 | 41.71% | 3.49% |
| 调料 | 80,011.15 | 19.67% | 14.26% |
| 散称干货 | 40,826.86 | 10.04% | 21.35% |
| 其他XY | 39,470.00 | 9.70% | 5.42% |
| 酱油醋 | 31,874.22 | 7.84% | 12.51% |
| 大米 | 19,700.00 | 4.84% | 7.51% |
| 面条面粉 | 11,422.50 | 2.81% | 14.05% |
| 一次性用品 | 8,695.46 | 2.14% | 10.11% |
| 九九 | 2,983.98 | 0.73% | 8.98% |
| 米线饵丝 | 2,111.00 | 0.52% | 9.95% |
读表的关键,是营收与毛利的反向:
- 油扛起了 41.71% 的营收,毛利率却只有 3.49%——走量不赚钱,是典型的「引流品」;
- 散称干货营收只占 10.04%,毛利率却高达 21.35%,是全品类里最赚钱的板块;
- 调料是「双高」板块:19.67% 营收 + 14.26% 毛利,是名副其实的利润基本盘。
这组数字直接改变经营动作:如果只盯营收排名,会不断加码毛利极薄的油;而真正该扩品、该加固供应链的,是高毛利的散称干货与调料。
业务层还暴露了一个治理问题:表里出现了 3 个「零实收」的空壳分类——散称(2 行)、秒杀特价商品(18 行)、餐饮推广专属产品(16 行),整月营收为 0。它们既不是真实品类,也不产生销售,属于商品主数据里的「僵尸分类」。此外,明细中甚至混进了香烟(云烟)——说明这张「调味品销售表」的主数据并没有做严格的品类治理。
3.3 集中度:20% 的单品,吃掉 94.5% 的营收
把 1,198 个单品按营收降序排列,做帕累托分析,集中度比预想的还要极端。
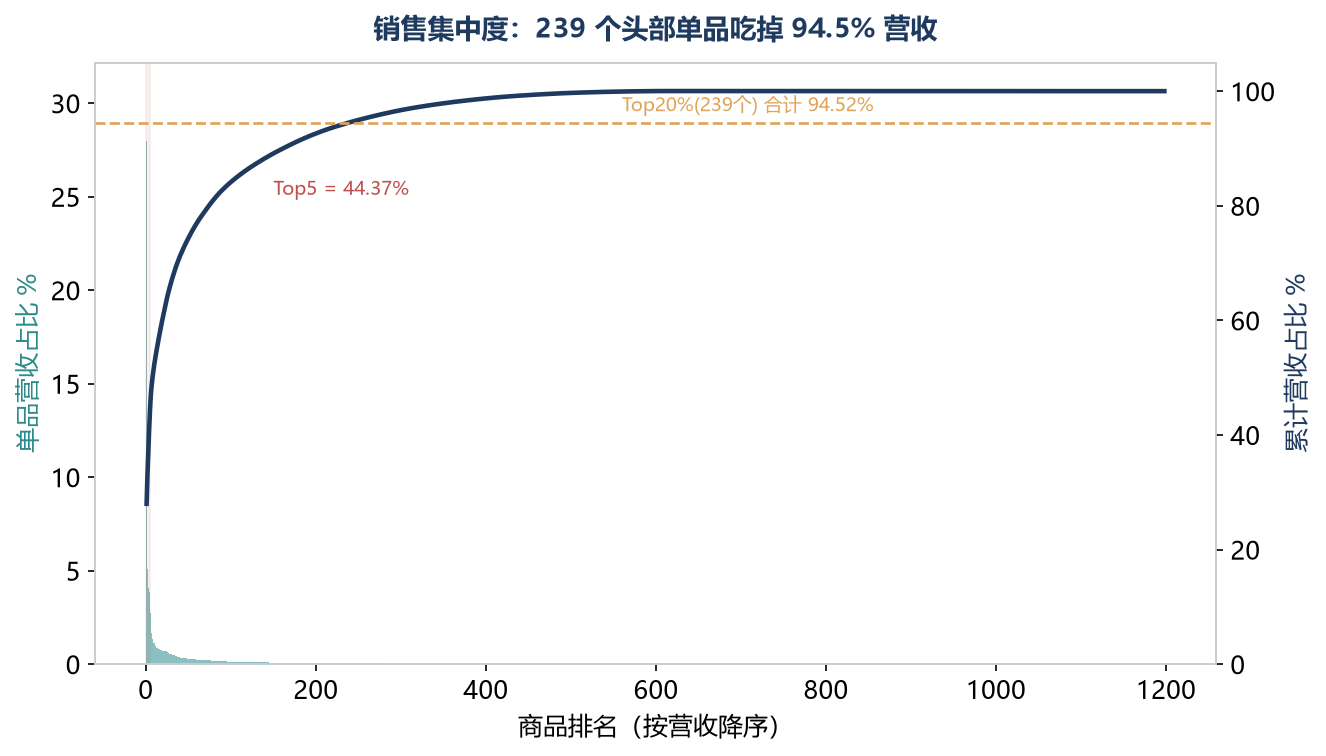
- Top 5 单品:合计占 44.37%;
- Top 10 单品:前 5 名之后依然陡增,头部效应极强;
- Top 20%(239 个)单品:合计占 94.52%。
| 排名 | 单品 | 单月实收(元) | 营收占比 | 毛利率 |
|---|---|---|---|---|
| 1 | 口福一级大豆油 20L | 113,818.58 | 27.98% | 2.24% |
| 2 | 罗正平罗平纯香 20L | 20,633.79 | 5.07% | 8.77% |
| 3 | 云烟(软珍品) | 16,628.00 | 4.09% | ≈0% |
| 4 | 云烟(紫) | 15,620.00 | 3.84% | 8.78% |
| 5 | 金宫特级鸡精升级版 454g | 13,785.89 | 3.39% | 5.96% |
这份榜单信息量很大:排名第一的口福一级大豆油 20L,一个单品就占了近 28% 的营收,毛利率却只有 2.24%。 公司的营收命脉,几乎系于一个薄利单品之上——这既是风险(一旦断供或价格波动,营收剧烈震荡),也是机会(这个 SKU 是极佳的客流入口,可用来牵引高毛利品类的连带销售)。
反过来,剩下 80% 的长尾 SKU(959 个)只贡献了 5.48% 的营收。它们消耗着采购、仓储、对账的管理成本,却几乎不产生收入。对这部分,理性的动作是做减法,而不是幻想把它们「养成爆品」。
3.4 异常层:谁在悄悄亏钱
把「利润为负」的行单独拎出来,亏损的分布同样清晰。
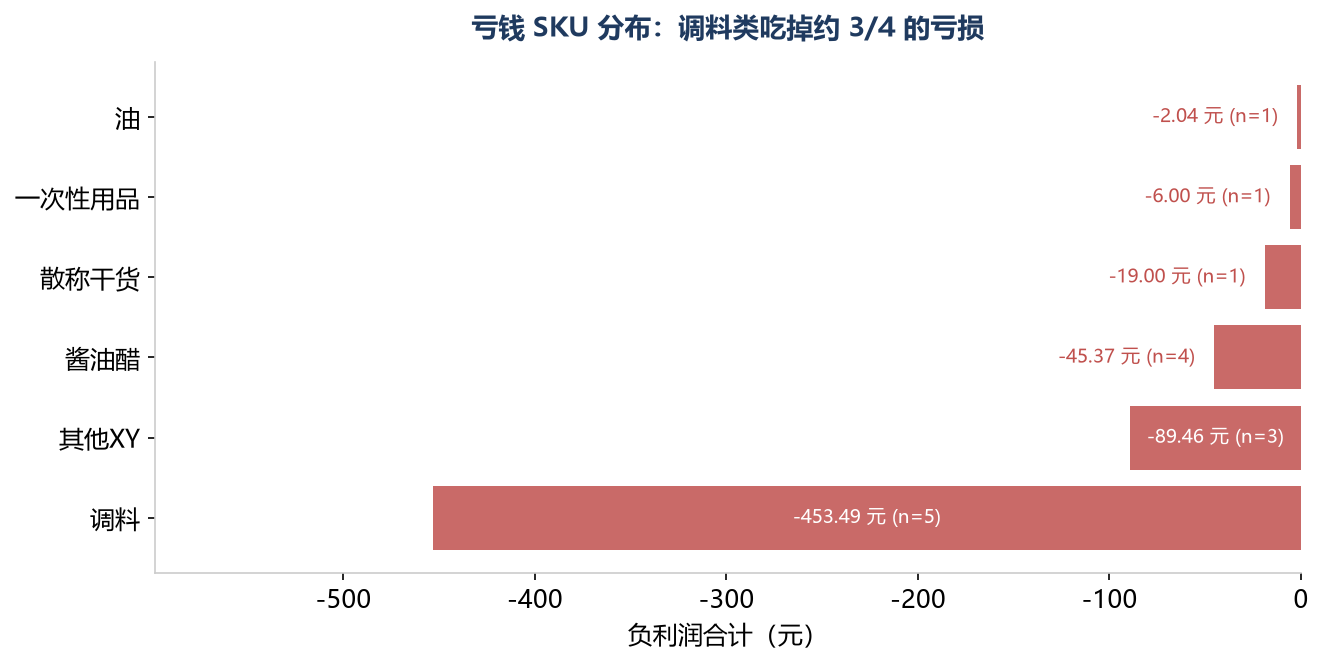
单月 15 条负利润 SKU 合计亏损 615.36 元,分布为:调料 -453.49(5 条)、其他XY -89.46(3 条)、酱油醋 -45.37(4 条)、散称干货 -19.00(1 条)、一次性用品 -6.00(1 条)、油 -2.04(1 条)。
金额虽小,但性质要区分:这些 SKU 大多「实收为正、利润为负」,典型成因是促销定价失误、进价上涨未同步调价、或临期清仓。它们单条亏损不大,却会持续侵蚀毛利,且往往被「总利润为正」的汇总数字掩盖。负利润扫描真正的价值,是让这些「温水里的亏损」显形,变成一份可执行的调价/替换清单。
3.5 成本与交付层:明细和指标,差了一个半数量级
分析到这里,还有一层容易被忽略的成本:数据体量。
单月明细的文本全量约 10.1 万字符(两份合计 20.2 万),粗估约 6.7 万 token;而真正驱动决策的核心指标——各品类营收/毛利、集中度、异常清单——压缩后仅约 2,000 字符。明细体量是有效指标的 30 倍以上。
这解释了一个常见误区:很多人习惯把整张几千行的明细直接丢给工具或模型去「读」,以为信息越多越好。实际上,明细里 90% 以上是重复与噪声,喂得越多,噪声越大、成本越高、结论越不稳。 正确做法是先把明细聚合成指标,再用指标驱动结论——先做减法,再做判断。
最终,这个案例沉淀下三份可直接使用的交付物:
- 数据体检表:行数、重复、汇总、零值、负利润、负库存一屏可见;
- 结构与集中度分析:品类营收/毛利 + 帕累托,一眼看清「钱在哪、利在哪」;
- 异常清单:负利润 SKU、负库存行、空壳分类,逐条对应到人。
四、经验总结
4.1 六步方法论:一套可复用的分析骨架
这个案例最有价值的产出,不是某个月的具体结论,而是一套换行业、换数据也能复用的分析骨架。
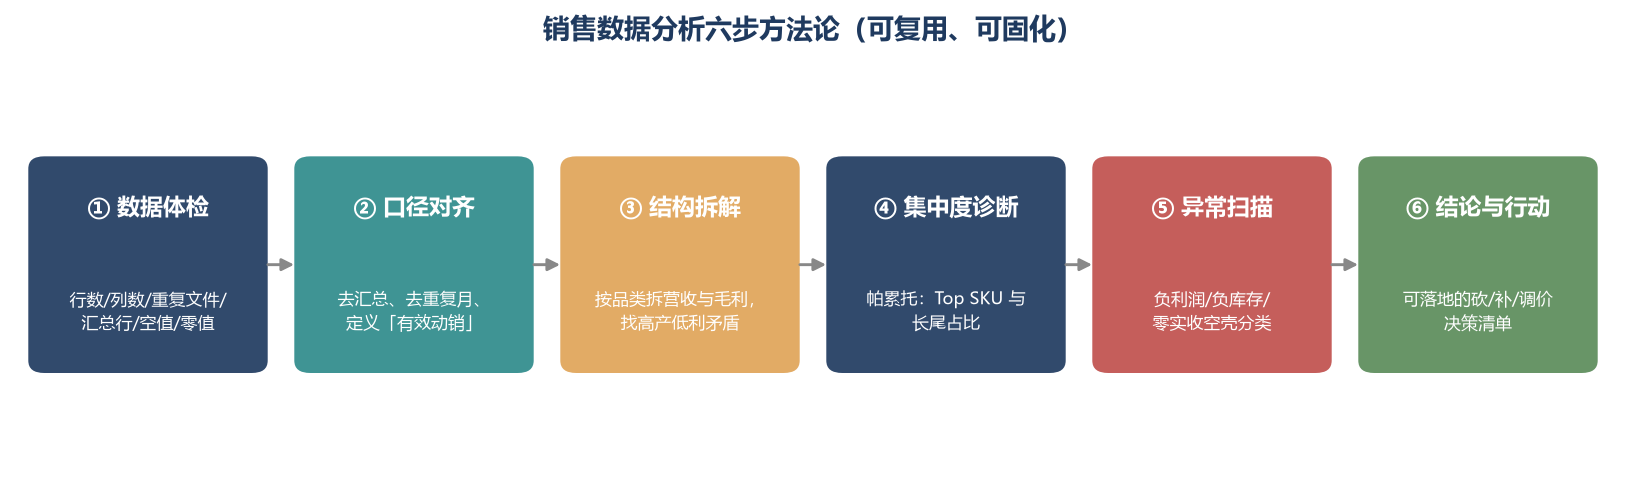
- 数据体检:先摸清行数、列结构、重复文件、汇总行、空值、零值,再谈分析。
- 口径对齐:去汇总行、去重复月、定义「有效动销」,把口径写死、写清。
- 结构拆解:按品类/区域/渠道拆营收与毛利,找「高产低利」与「低产高利」的结构矛盾。
- 集中度诊断:用帕累托判断业务是「头部驱动」还是「长尾驱动」,为库存与采购定优先级。
- 异常扫描:负利润、负库存、零实收空壳分类,逐条定位漏点与雷点。
- 结论与行动:把分析翻译成可落地的决策——哪些该砍、哪些该补、哪些该调价。
这套骨架的复用性在于:前两步与行业无关(任何表都要体检、都要对齐口径),后四步与业务相关(不同行业关注的品类和异常不同)。 把前两步固化成流程,每次分析就能省掉最容易出错、也最重复的部分。
4.2 五个高频避坑点
- 别把「文件数」当「数据量」。 相似命名的多份文件,先用关键字段做去重,确认是否同源,再谈趋势。
- 别对含汇总行的表直接求和。 「总计」行是给人看的,不是给公式算的,处理前必须剔除。
- 别让零销量行参与统计。 六成零销量记录会严重稀释均值、干扰对比,分析前先按销量过滤。
- 别用重复表做环比。 两个月看似到手,实为一份数据,趋势结论会南辕北辙。
- 别用汇总掩盖异常。 总利润为正,不代表没有亏损 SKU;异常必须单独扫描。
4.3 按角色的 Actionable Insights
给老板与决策者:
- 先看两个数——有效动销 SKU 数(本例 733)和真实单月营收(本例 40.68 万),别被总行数吓到;
- 用集中度做取舍:Top 20% 单品贡献 94.52% 营收,库存与采购资源应向头部倾斜,而非平摊到千余个 SKU。
给运营与数据分析者:
- 建立一份月度数据体检清单(行数、重复、汇总行、零值、负利润、负库存),每月先跑体检再看业务;
- 把「体检 + 结构 + 异常」的分析逻辑固化下来,让同格式数据可复用,而不是每月从头来过。
给采购与选品:
- 对负利润 SKU(尤其调料类)做调价或替换,别让它们在汇总数字里「藏亏」;
- 高毛利、低占比的散称干货考虑扩品上架;
- 对贡献不足 6% 营收的 959 个长尾 SKU,做定期清理与汰换。
给财务:
- 统一金额口径(实收金额 / 商品总售价 / 利润三列含义不同),确保各岗位汇报的数字用同一把尺子。
4.4 不适用边界
任何一种方法都有边界,本案例的方法论同样如此:
- 它针对「单表 / 同结构月结表」设计。多源异构数据(订单、库存、财务分属不同系统)需先做 ETL 整合;
- 它回答「是什么、在哪里」,不直接回答「为什么」。要归因负利润的根因(进价、损耗、还是定价),单表缺少成本明细,需要补采购价与损耗数据;
- 品类与异常的判定依赖业务经验:哪些负库存可忽略、哪些空壳分类要清理,仍需熟悉业务的人来拍板。
小结
回到最初的问题:如何分析销售数据?
这个案例给出的答案并不复杂:先别急着算,先给数据做体检;先做减法,把六成噪声去掉,剩下的三分之一才是真信号;再把分析逻辑固化下来,让下个月不用从零开始。
一张 1,908 行的月结表,肉眼看到的是「全是数」;拆开之后,真信号只有 19.2%,利润集中在 10% 的品类、94.5% 的头部单品,亏损藏在 15 条不起眼的记录里。销售数据分析的难点,从来不是算得不够多,而是看得不够清。
参考资料:
· 某区域调味品供应链公司:《8 月份商品销售统计表》《9 月份商品销售统计表》,各 1,908 行 × 15 列,内部经营数据,2026 年。
· 复算脚本:
_analyze_and_charts_2026-10-17.py(纯 zipfile + XML 解析,无第三方依赖,结果可逐项复现)。· 帕累托法则(二八定律):维尔弗雷多·帕累托关于收入分配的研究,后被广泛用于销售集中度与库存 ABC 分类分析。
· 中国信息通信研究院:企业私有化/本地化部署大模型的相关行业研究口径。
更多数据实战案例
数据本地处理、口径可固化、逻辑可复用。前往文章中心,查看完整的销售、库存、财务、HR 实战案例合集。